Tienes un PDF de 20 páginas — un ensayo, un informe, una tesis, un artículo de un freelancer — y necesitas verificar si contiene texto generado por IA. ¿Cómo lo haces? La mayoría de los detectores de IA están diseñados alrededor de una caja de texto donde pegas un fragmento, pero los documentos reales vienen en PDF, Word o Google Docs. Analizar un archivo completo con un detector de IA para PDF requiere un flujo de trabajo específico que pocos usuarios conocen. Esta guía te explica paso a paso cómo preparar, segmentar y analizar cualquier documento de forma efectiva.
Analizar el documento completo — no solo un párrafo — es importante porque el uso de IA puede estar concentrado en secciones específicas. Un autor podría haber escrito la introducción y la conclusión por su cuenta pero generado el desarrollo con ChatGPT. Un único análisis del documento completo daría una puntuación intermedia que no dice nada concreto; el análisis por secciones te muestra dónde se concentran las señales. Para entender este fenómeno, consulta nuestra guía sobre texto mixto humano + IA. Y si todavía no tienes claro cómo funcionan los detectores, empieza por qué es un detector de IA.
Contenido
- Qué herramientas permiten subir PDFs
- Flujo de trabajo: cómo analizar un PDF paso a paso
- Qué excluir del análisis (y por qué)
- Consideraciones para documentos largos
- Nuestra herramienta: limitaciones y ventajas
- Preguntas frecuentes
Qué herramientas permiten subir PDFs directamente
No todas las herramientas de detección de IA aceptan archivos. Muchas solo permiten pegar texto, lo que obliga a un proceso manual de extracción que introduce errores y pierde contexto de formato. Las opciones de subida y los límites gratuitos de cada servicio cambian a menudo, así que en lugar de una lista que quedaría desfasada, esta tabla resume qué conviene comprobar en cualquier detector antes de subirle un documento:
| Qué comprobar | Por qué importa | En Detector de IA |
|---|---|---|
| ¿Acepta PDF y Word, o solo texto pegado? | Si solo admite texto pegado, tendrás que extraerlo tú y revisar que no se cuelen encabezados, notas o saltos de línea rotos. | Acepta .pdf, .docx y .txt de hasta 5 MB. |
| ¿Dónde se procesa el archivo? | Un documento puede contener datos personales. Si se sube a un servidor, revisa qué dice su política de privacidad. | El archivo se lee en tu navegador; solo se envía el texto que confirmas. |
| ¿Puedes revisar el texto extraído? | La extracción de un PDF falla con tablas, columnas o fórmulas. Ver el texto antes de analizarlo evita errores. | El texto extraído aparece en la caja para que lo edites. |
| ¿Lee PDFs escaneados (OCR)? | Un PDF escaneado es una imagen: sin OCR no hay texto que analizar. | No. Pasa antes el PDF por un programa de OCR. |
| ¿Qué límite de longitud tiene? | Los documentos largos suelen superar el límite y hay que analizarlos por secciones. | De 150 palabras a 25.000 caracteres por análisis. |
| ¿Está entrenado en español? | Un detector pensado para inglés puede fallar más con textos en español. | Sí, solo con textos en español. |
Para conocer qué admite hoy otro servicio, consulta su página de ayuda o de precios: son la única fuente fiable, porque sus planes cambian con frecuencia.
Nuestra herramienta acepta archivos PDF, Word (.docx) y .txt de hasta 5 MB: el archivo se lee en tu propio navegador, no se sube, y el texto extraído aparece en la caja para que lo revises antes de analizarlo. Además es gratuita, no requiere registro y está optimizada para español, lo que la convierte en una excelente opción como segundo detector o para análisis sección por sección. Para una comparativa más completa, consulta nuestra guía de los mejores detectores de IA en 2026.
Flujo de trabajo: cómo analizar un PDF con un detector de IA paso a paso
Tanto si usas una herramienta con subida de archivos como si necesitas pegar texto manualmente, este flujo de trabajo en 6 pasos te asegura resultados fiables y bien organizados.
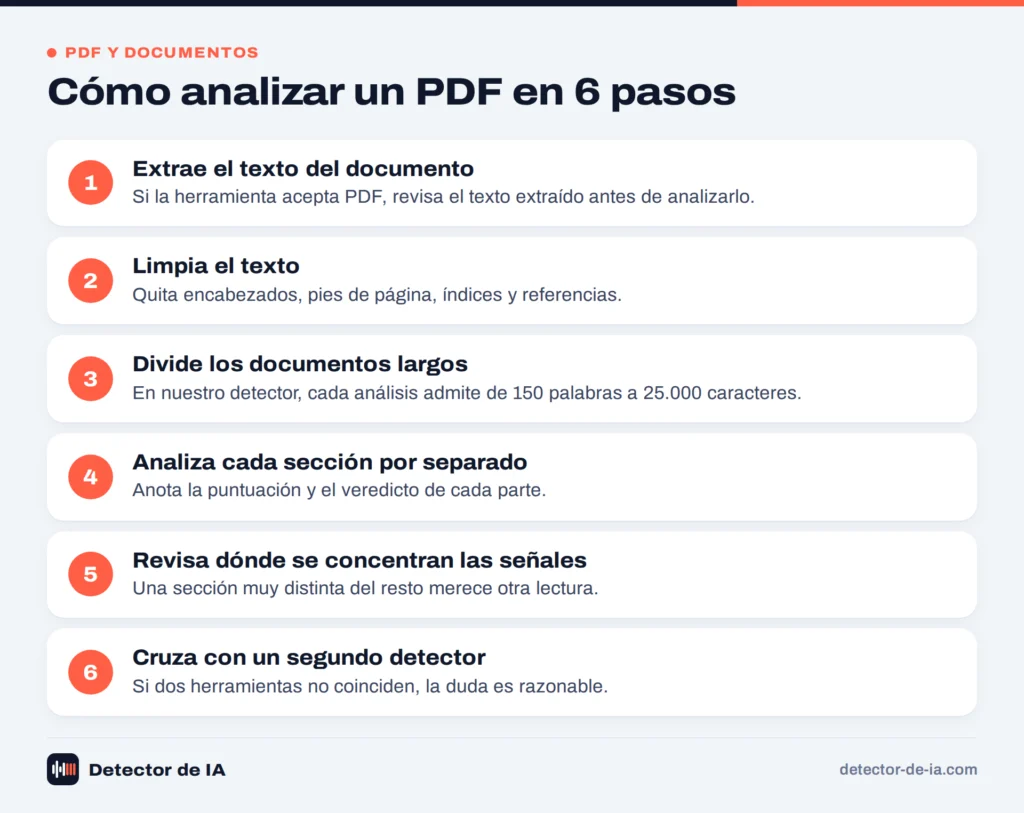
Paso 1: Extrae el texto del documento
Si tu PDF es digital (creado desde Word, Google Docs o un editor de PDF), puedes seleccionar todo el texto (Ctrl+A) y copiarlo directamente. Asegúrate de que la estructura de párrafos se mantenga al pegar — no colapses todo en un solo bloque de texto sin saltos de línea. Si copias desde un PDF con columnas (común en artículos científicos), verifica que el texto se copió en el orden correcto: algunos lectores de PDF mezclan las columnas al copiar.
Si tu documento es un PDF escaneado (una imagen de un texto impreso, como una fotocopia o un documento antiguo), necesitas aplicar OCR (reconocimiento óptico de caracteres) antes de poder analizarlo. La forma más sencilla: sube el PDF a Google Drive, ábrelo con Google Docs — el sistema aplica OCR automáticamente — y copia el texto resultante. Adobe Acrobat y herramientas online como OCR.space también funcionan. Para documentos Word (.docx), simplemente abre el archivo y copia el texto — no necesitas conversión adicional.
Paso 2: Limpia el texto antes de analizar
Este paso es crucial y la mayoría de usuarios lo omite. Antes de pasar el texto por un detector, elimina todo lo que no sea prosa narrativa del autor: encabezados y pies de página, números de página, índice, bibliografía, citas textuales entre comillas, tablas con datos numéricos y pies de figura. También elimina agradecimientos, declaraciones de conflicto de intereses y notas al pie con información administrativa.
¿Por qué es tan importante esta limpieza? Porque estos elementos tienen un formato formulista que activa falsos positivos. Una bibliografía en formato APA se parece estadísticamente al texto de IA por su estructura repetitiva y predecible — pero eso no significa que fue generada artificialmente. Del mismo modo, las citas textuales son palabras de otro autor, no del evaluado, e incluirlas distorsiona el perfil estadístico del texto.
Paso 3: Divide documentos largos en secciones
Como regla práctica, trabaja con fragmentos de entre 500 y 1.000 palabras: son lo bastante largos para dar una señal estable y lo bastante cortos para saber de dónde viene. En nuestro detector, los umbrales se calibran por tramos de longitud (150–299, 300–599 y 600 o más palabras), y en la prueba sellada que describe nuestra metodología detectó más texto de IA en el tramo de 600 palabras o más (unos 6 de cada 10) que en los tramos más cortos (unos 5 de cada 10). Si tu documento tiene 5.000 palabras o más, no lo analices todo de una vez — los resultados serán un promedio que oculta dónde están realmente las señales. Divide por las secciones naturales del documento: introducción, marco teórico, metodología, resultados, discusión, conclusión. Cada sección es un análisis independiente. Evita fragmentos menores de 150 palabras — nuestro detector no los analiza, porque por debajo de ese umbral los resultados son poco fiables, como explicamos en textos cortos y fiabilidad.
Paso 4: Analiza cada sección por separado
Pega cada sección en tu detector de IA y registra la puntuación (de 0 a 100) y el veredicto de cada una: «Probablemente humano», «Incierto» o «Probablemente IA». Este método de análisis por secciones es mucho más informativo que un único resultado global. Un documento puede ser casi todo humano con una sola sección generada por IA — un resultado global diluiría esa señal y no sabrías dónde buscar. El desglose por secciones te dice exactamente qué parte revisar. Para ver cómo se lee un análisis completo, consulta nuestro informe de ejemplo.
Paso 5: Revisa dónde y por qué se concentran las señales
Para las secciones con puntuaciones elevadas, relee el texto con atención. ¿Son frases introductorias genéricas («En el presente trabajo se analiza…»)? Eso podría ser un falso positivo por lenguaje académico formulista. ¿Son párrafos completos con un estilo uniforme que contrasta con el resto? Eso es una señal más consistente. Nuestro detector no marca oraciones concretas, pero su apartado «¿Por qué?» muestra cómo se sitúa el texto en previsibilidad, ritmo de las frases y vocabulario; si otro detector ofrece un desglose frase por frase, úsalo como complemento. Para interpretar estos resultados correctamente, consulta nuestra guía sobre cómo interpretar el resultado del detector.
Paso 6: Cruza con un segundo detector
Pasa las secciones marcadas por una segunda herramienta. Si dos detectores independientes coinciden en señalar las mismas secciones, la señal es más fiable. Si uno da un resultado alto y el otro uno bajo para el mismo fragmento, eso indica ambigüedad — investiga más antes de concluir. Consulta nuestra comparativa de detectores para elegir la segunda herramienta. Y recuerda que los humanizadores de IA pueden hacer que un texto engañe a un detector pero no a otro.
¿Listo para analizar tu documento? Carga el archivo (.txt, .docx o .pdf) o pega el texto sección por sección en nuestro detector de IA gratuito — sin registro y optimizado para español. Recuerda que cada sección necesita al menos 150 palabras: abre el detector y empieza por la sección que más dudas te genere.
Qué excluir del análisis (y por qué)
Saber qué quitar antes de analizar es tan importante como saber qué analizar. Incluir elementos formulistas o prestados distorsiona los resultados y genera señales que no tienen nada que ver con el uso de IA por parte del autor.
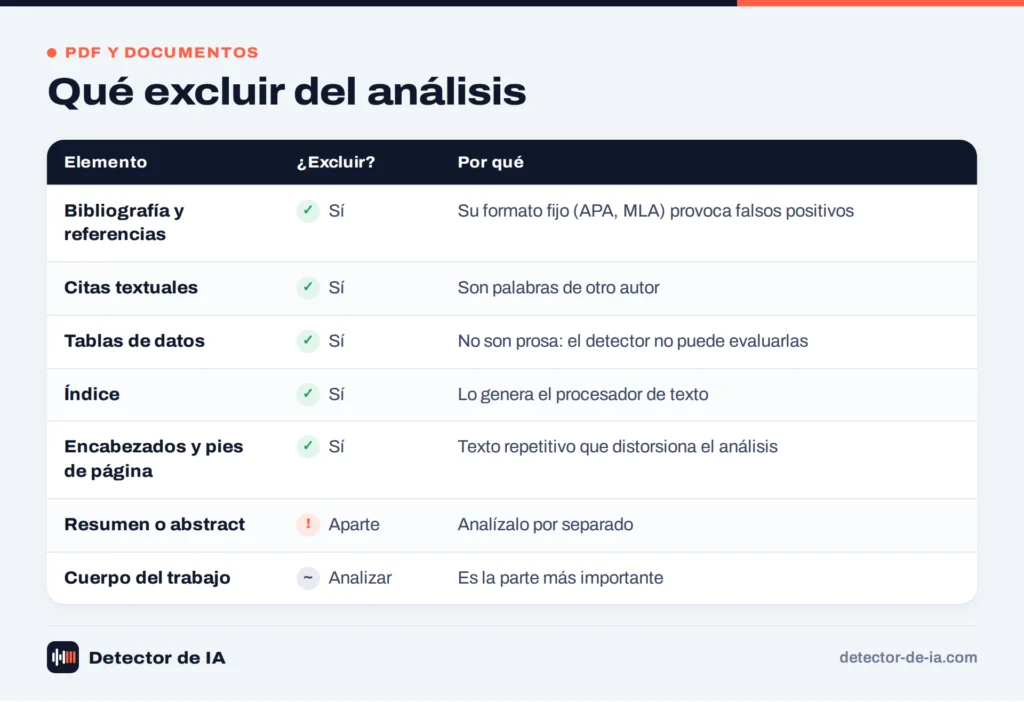
| Elemento | ¿Excluir? | Razón |
|---|---|---|
| Bibliografía / referencias | ✅ Sí | Formato formulista (APA, MLA) que activa falsos positivos |
| Citas textuales | ✅ Sí | Son palabras de otro autor, no del evaluado |
| Tablas de datos numéricos | ✅ Sí | No son prosa narrativa — el detector no puede evaluarlas |
| Índice / tabla de contenidos | ✅ Sí | Generado automáticamente por el procesador de texto |
| Encabezados y pies de página | ✅ Sí | Texto repetitivo que distorsiona el análisis |
| Resumen / abstract | ⚠️ Aparte | Analizar por separado — alto riesgo de falso positivo pero también de uso de IA |
| Cuerpo principal (desarrollo) | ✅ Analizar | Esta es la sección más importante del análisis |
Guía de qué incluir y qué excluir al analizar un documento con un detector de IA.
Consideraciones especiales para documentos largos
Para documentos de más de 5.000 palabras (tesis, informes extensos, trabajos de investigación), analiza al menos 4-6 secciones independientes. Lo más revelador no es el promedio global sino la consistencia entre secciones: si la introducción, el marco teórico y la metodología salen con puntuaciones bajas y el veredicto «Probablemente humano», y de repente la discusión obtiene una puntuación muy alta y el veredicto «Probablemente IA», esa disparidad te dice exactamente dónde mirar. Una única puntuación global ocultaría por completo esta información. Registra los resultados en una tabla simple (sección, palabras, puntuación, veredicto) para tener una visión completa del documento.
Ten en cuenta que ciertas secciones de documentos académicos son naturalmente más «formulistas» que otras. Las secciones de metodología en artículos científicos suelen usar un lenguaje estandarizado («Se aplicó un diseño cuasi-experimental con una muestra de…») que puede activar señales de IA sin que haya IA involucrada. Lo mismo ocurre con los resúmenes y abstracts. No interpretes una puntuación moderada en estas secciones como evidencia concluyente — considérala en el contexto del documento completo. Para entender mejor estos matices, consulta nuestros artículos sobre ¿puede equivocarse un detector? y los límites del detector de IA. Si eres docente evaluando trabajos de estudiantes, nuestra guía para profesores ofrece un protocolo completo para estas situaciones. Y si eres estudiante preocupado por un posible falso positivo, consulta nuestra guía de defensa.
Un matiz importante para trabajos académicos: en nuestra prueba sellada, los párrafos académicos y los ensayos breves de estudiantes estuvieron entre los géneros que el detector identificó con menos frecuencia cuando los había escrito una IA. Por eso un «Probablemente humano» en una sección académica no garantiza que no haya IA, y un «Incierto» no es motivo de sospecha por sí solo: significa que las señales no son concluyentes. Y aunque el detector está calibrado para acusar poco, alrededor de 1 de cada 70 u 80 textos humanos, según la longitud, recibió por error el veredicto «Probablemente IA». Ningún resultado sustituye a una conversación con el autor ni a la revisión de sus borradores.
Nuestra herramienta: limitaciones y ventajas para documentos
Seamos transparentes: nuestro detector de IA acepta archivos PDF, Word (.docx) y .txt de hasta 5 MB, pero los lee en tu navegador y solo extrae su texto: no lee PDFs escaneados (imágenes sin capa de texto) y cada análisis admite entre 150 palabras y 25.000 caracteres. Esto significa que para analizar un documento largo necesitas seguir el flujo de trabajo descrito arriba: revisar el texto extraído, limpiarlo, segmentarlo y analizar sección por sección. Requiere algo más de trabajo, pero te da un resultado por sección en lugar de un único número para todo el documento.
Cómo leer cada resultado: la puntuación va de 0 a 100 y no es una probabilidad ni el porcentaje del texto escrito por IA. Junto a ella verás uno de tres veredictos («Probablemente humano», «Incierto» o «Probablemente IA»), una barra con las zonas y un apartado «¿Por qué?» con las tres señales que mide el detector (previsibilidad, ritmo de las frases y vocabulario), cada una en una escala de cinco pasos. El detector no marca frases concretas ni identifica qué chatbot escribió el texto, así que el análisis por secciones es la forma de localizar dónde están las señales.
Lo que sí ofrecemos es un análisis completamente gratuito, sin registro y optimizado específicamente para texto en español. Tu contenido no se almacena — se descarta tras generar el resultado, como detallamos en nuestra política de privacidad. Para un flujo de trabajo completo de documentos, te recomendamos cargar el archivo en nuestro detector, revisar el texto extraído y analizarlo por secciones, y después contrastar las secciones marcadas con una segunda herramienta (por ejemplo, GPTZero o Copyleaks). Este enfoque combinado te da la comodidad de cargar el archivo directamente más el contraste de una segunda opinión. Si usas Turnitin en tu institución, nuestro detector puede complementar ese análisis. Para señales específicas de ChatGPT, consulta nuestra guía sobre cómo detectar texto de ChatGPT. Más información en cómo funciona, nuestras preguntas frecuentes, o conoce al equipo en sobre nosotros. También puedes consultar nuestra metodología y el rendimiento en español vs inglés.
Preguntas frecuentes
¿Se puede subir un PDF directamente a un detector de IA?
Depende de la herramienta: varios detectores comerciales permiten subir archivos, pero conviene comprobar en la web de cada uno qué formatos y límites aplican. El nuestro también acepta archivos .pdf, .docx y .txt de hasta 5 MB: los lee en tu navegador, sin subirlos, y muestra el texto extraído para que lo revises antes de analizarlo. Otros detectores solo permiten pegar el texto. Si el documento supera los 25.000 caracteres, analízalo por secciones.
¿Qué hago con un PDF escaneado (imagen)?
Necesitas aplicar OCR (reconocimiento óptico de caracteres) antes de poder analizarlo. La forma más sencilla es subir el PDF a Google Drive y abrirlo con Google Docs — el sistema aplica OCR automáticamente. También puedes usar Adobe Acrobat o herramientas online como OCR.space. Una vez extraído el texto, sigue el flujo de trabajo normal.
¿Debo analizar las referencias bibliográficas?
No. Elimina la bibliografía antes de analizar. El formato de las referencias (APA, MLA, Chicago) es repetitivo y formulista por diseño, lo que activa falsos positivos en los detectores. Solo analiza la prosa narrativa del documento — el cuerpo principal donde el autor expresa sus ideas propias.
¿Cuántas palabras necesito para un resultado fiable?
Nuestro detector necesita un mínimo de 150 palabras de prosa continua por sección (no analiza textos más cortos) y admite hasta 25.000 caracteres por análisis; sus umbrales están calibrados por tramos de longitud (150–299, 300–599 y 600 o más palabras). Para documentos largos, divide por secciones naturales (introducción, desarrollo, conclusión) y analiza cada una por separado. Para más detalle, consulta textos cortos y fiabilidad.
¿Por qué un mismo documento da resultados diferentes en distintos detectores?
Porque cada detector usa modelos, datos de entrenamiento y umbrales diferentes. Es completamente normal que un detector dé un resultado alto y otro uno moderado para el mismo texto; además, no todos usan la misma escala: algunos dan un porcentaje y el nuestro, una puntuación de 0 a 100 con un veredicto. Por eso recomendamos usar al menos dos detectores: las señales que coinciden en ambos son más fiables que las que solo aparecen en uno.