Cómo funciona
Cómo funciona el Detector de IA
Sin cajas negras: qué hacemos con tu texto, qué medimos y cómo decidimos el veredicto.
El Detector de IA analiza textos en español y te dice si se parecen más a la escritura de una persona o a la de un modelo de inteligencia artificial. No hay cajas negras: en esta página explicamos qué ocurre con tu texto desde que lo pegas hasta que ves el veredicto, qué medimos exactamente, cómo fijamos los umbrales y qué límites tiene la herramienta.
Paso a paso
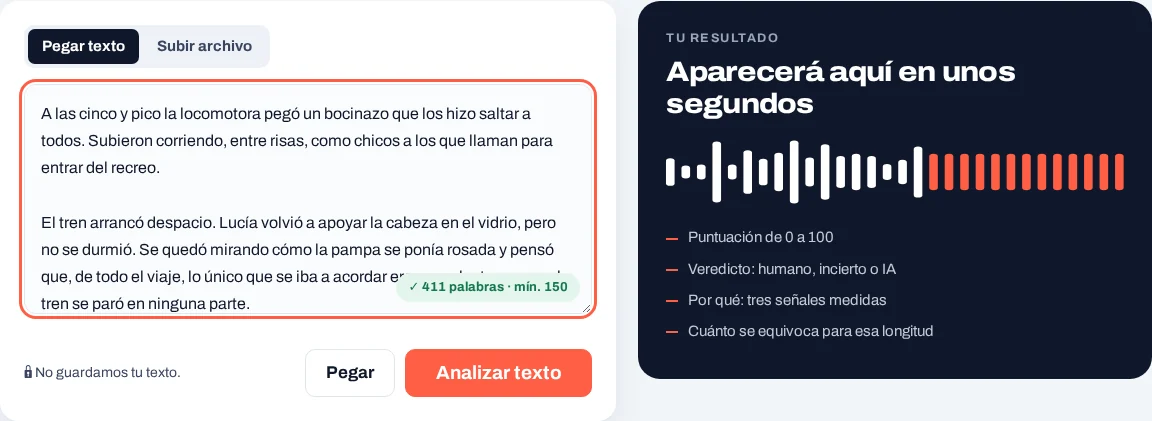
- Pegas o subes tu texto Mínimo 150 palabras en español y como máximo 25.000 caracteres. Si eliges «Subir archivo», el .txt, .docx o .pdf se lee en tu navegador: el archivo nunca se sube, solo el texto que ves en el recuadro.
- Un modelo de lenguaje en español lo lee Calcula qué tan esperable es cada palabra en su contexto, frase a frase, y mide cómo varían las frases y el vocabulario a lo largo del texto.
- Medimos tres señales Previsibilidad, ritmo de las frases y vocabulario, junto con otras mediciones estadísticas: más de cuarenta en total.
- Calibramos el veredicto según la longitud Un clasificador combina las mediciones en una puntuación de 0 a 100 y la compara con los umbrales del tramo de longitud de tu texto. Un texto corto y uno largo no se juzgan igual.
Todo el proceso tarda unos segundos. El texto se analiza en nuestros propios servidores y se descarta al terminar: no lo guardamos, no lo compartimos con terceros y no lo usamos para entrenar el detector. Para limitar el abuso aplicamos un límite de uso razonable por conexión; para ello guardamos durante 24 horas un código irreversible derivado de la dirección IP, nunca la dirección ni el texto.
Las tres señales
Previsibilidad
Un modelo de lenguaje en español mide si cada palabra es la más esperable en su lugar. La IA tiende a elegir lo previsible; las personas se salen del guion más a menudo.
Ritmo de las frases
Las personas alternan frases largas y cortas, con pausas y aceleraciones. La IA suele escribir con un ritmo más uniforme.
Vocabulario
Medimos la variedad de palabras en ventanas del texto. En nuestros datos, la IA repite menos palabras que muchas personas, al contrario de lo que se suele pensar.
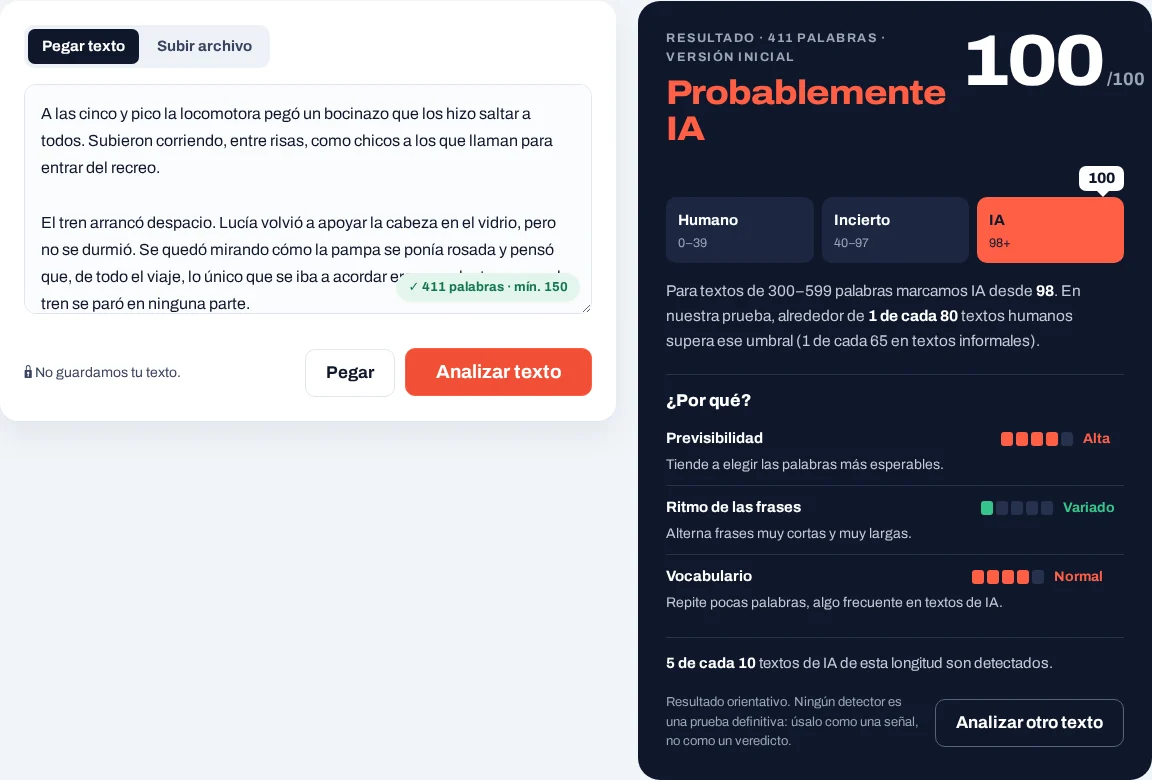
Estas tres señales son las que ves en el apartado «¿Por qué?» del resultado. Cada una aparece en una escala de cinco pasos: a la izquierda, lo típico de un texto humano de tu misma longitud; a la derecha, lo típico de un texto de IA. El color indica hacia dónde se inclina esa señal: verde si se parece a la escritura humana, coral si se parece a la de IA y gris si queda en medio. Además, la palabra de nivel resume la medición: Previsibilidad Alta, Media o Baja; Ritmo Uniforme o Variado; Vocabulario Normal o Repetitivo.
Las señales describen el texto, pero el veredicto no se decide por ninguna de ellas en solitario. Es habitual que una señal apunte a IA y otra a escritura humana; lo que cuenta es la combinación, y eso es lo que hace el clasificador. Por eso puedes ver un «Probablemente humano» con la previsibilidad en coral, o un «Probablemente IA» con el ritmo en verde.
Cómo se decide el veredicto
El clasificador se entrenó con unos 25.000 fragmentos en español escritos por personas —enciclopedia, debates parlamentarios, textos legales, literatura de dominio público y, sobre todo, texto informal de internet— y con cerca de 1.900 textos generados con varias familias de modelos de IA, entre ellas las de ChatGPT, Gemini, Claude, DeepSeek y Qwen. Aprendió qué combinación de mediciones separa mejor unos de otros y devuelve una puntuación de 0 a 100. Esa puntuación no es una probabilidad ni el porcentaje del texto escrito por una máquina.
Después, la puntuación se lee con tres zonas: «Probablemente humano», «Incierto» y «Probablemente IA». Los límites de las zonas cambian con la longitud del texto, y el umbral de IA se eligió para que las falsas alarmas sean raras. El precio de esa prudencia es que el detector deja pasar aproximadamente la mitad de los textos de IA.
Por qué calibramos por longitud
La longitud cambia mucho lo que se puede medir. En un texto de 200 palabras hay pocas frases y cada una pesa mucho en el ritmo; en uno de 900, las señales se estabilizan y los patrones se ven con más claridad. Si usáramos el mismo umbral para todos, los textos cortos generarían muchas más falsas alarmas o los largos pasarían sin control.
Por eso dividimos los textos en tres tramos —150 a 299 palabras, 300 a 599 y 600 o más— y fijamos para cada uno su propio umbral con el mismo criterio: que el porcentaje de textos humanos marcados como IA sea bajo. El resultado es que el número a partir del cual marcamos IA cambia (95, 98 y 96) y también el punto en el que empieza la zona «Incierto» (55, 40 y 27). Por debajo de 150 palabras no hay señales suficientes, así que el detector no analiza el texto.
Qué textos analiza mejor
El detector funciona mejor con prosa continua de cierta extensión: artículos, ensayos, informes, entradas de blog, relatos o respuestas largas. En la prueba sellada detectó con más frecuencia la IA en textos de blog, noticias, relatos y guías prácticas que en géneros muy breves o formulaicos. Si tu texto mezcla muchas listas, tablas, citas o fórmulas, quita esas partes antes de analizarlo: no las escribió el autor con su propio ritmo y distorsionan la medición.
Umbrales y márgenes de error
Estos son los umbrales de cada tramo y los errores medidos en nuestra prueba sellada: un conjunto de textos que se fijó antes de entrenar, nunca se usó para ajustar el modelo y se abrió una sola vez.
| Longitud | Marcamos IA desde | Humanos marcados por error | En textos informales | IA detectada |
|---|---|---|---|---|
| 150–299 palabras | 95 | 1 de cada 80 | 1 de cada 70 | 5 de cada 10 |
| 300–599 palabras | 98 | 1 de cada 80 | 1 de cada 65 | 5 de cada 10 |
| 600 o más palabras | 96 | 1 de cada 70 | 1 de cada 55 | 6 de cada 10 |
«Humanos marcados por error» es la proporción de textos escritos por personas que superaron el umbral de IA. «En textos informales» es esa misma cifra solo para texto de blogs, foros, tiendas y webs de noticias, el tipo de texto más parecido a lo que la gente suele pegar. «IA detectada» es la proporción de textos generados con IA que el detector marcó como «Probablemente IA». Los intervalos de confianza, las fuentes de datos y sus licencias están en la metodología.
Qué hacer con el resultado
- «Probablemente humano»: no hay señales fuertes de IA. No es una garantía, pero no hay motivo para sospechar solo por el detector.
- «Incierto»: las señales no son claras. Analiza un fragmento más largo o revisa el contexto antes de sacar conclusiones.
- «Probablemente IA»: el texto se parece mucho a los de IA de su longitud. Revísalo con más información —borradores, historial, una conversación— antes de decidir nada.
Si quieres ver cada veredicto con capturas y ejemplos, consulta cómo interpretar un resultado. Y si te han marcado un texto que escribiste tú, empieza por nuestra guía sobre falsos positivos.
Lo que el detector no hace
- No marca frases concretas: da un resultado para el texto completo.
- No es una prueba definitiva de autoría ni identifica qué chatbot se usó.
- Solo analiza textos en español de 150 palabras o más.
- No guarda tu texto ni lo usa para entrenar.
Limitaciones que conviene conocer
Es una versión inicial y tiene puntos débiles conocidos. Detecta con menos frecuencia la IA en cartas de presentación, publicaciones para redes sociales, párrafos académicos y redacciones escolares cortas, porque en esos géneros personas y modelos escriben de forma muy parecida. Un texto de IA editado a mano o pasado por un «humanizador» puede quedar en «Incierto» o pasar como humano. Y los textos formales y muy correctos, escritos por personas, son los que con más frecuencia se acercan a la zona de IA.
También importa lo que no hemos medido: los textos humanos de la prueba proceden sobre todo de la web y de registros formales anteriores a 2022, y no incluyen redacciones de estudiantes ni correos personales. Por eso tratamos el resultado como una señal y no como un veredicto, y por eso publicamos las cifras. Si encuentras un caso que te parece claramente erróneo, escríbenos: nos ayuda a mejorar la siguiente versión.
Preguntas rápidas
¿Puedo analizar solo una parte de un documento?
Sí, siempre que el fragmento tenga al menos 150 palabras. Es útil cuando sospechas de una sección concreta: analízala por separado y compara con el resto. Ten en cuenta que los fragmentos cortos dan resultados menos estables, así que no saques conclusiones de una sola sección.
¿Por qué dos textos parecidos dan puntuaciones distintas?
Porque la puntuación depende de la combinación de muchas mediciones y de la longitud. Un cambio de tramo —por ejemplo, pasar de 290 a 310 palabras— cambia también los umbrales. Fíjate más en el veredicto y en la zona que en el número exacto.
¿El detector aprende de lo que analizo?
No. El modelo está fijo y no se reentrena con los textos de los usuarios, que no se guardan. Las mejoras llegan en versiones nuevas entrenadas con datos propios, que se miden de nuevo con una prueba sellada antes de publicarlas.