La detección de texto generado por inteligencia artificial no es magia: es un proceso estadístico con aciertos y errores medibles. Esta página describe cómo funciona la versión actual de nuestro Detector de IA: con qué textos se entrenó y con qué licencias, cómo construimos y sellamos la prueba con la que lo medimos, qué señales mira, cómo convierte esas señales en una puntuación y un veredicto, qué resultados obtuvo y dónde falla.
Lo publicamos porque una herramienta que puede influir en decisiones sobre personas —una nota, una sospecha en clase, una revisión editorial— tiene que poder explicarse. Si vas a usar el detector con un ensayo, un artículo o un documento profesional, mereces saber qué mide, qué no mide y con qué frecuencia se equivoca. Si algo no aparece en esta página, no lo afirmamos.
Si prefieres una explicación más visual y menos técnica, empieza por cómo funciona el detector. Si ya tienes un resultado delante y quieres entenderlo, lee cómo interpretar un resultado del detector de IA.
La metodología en resumen
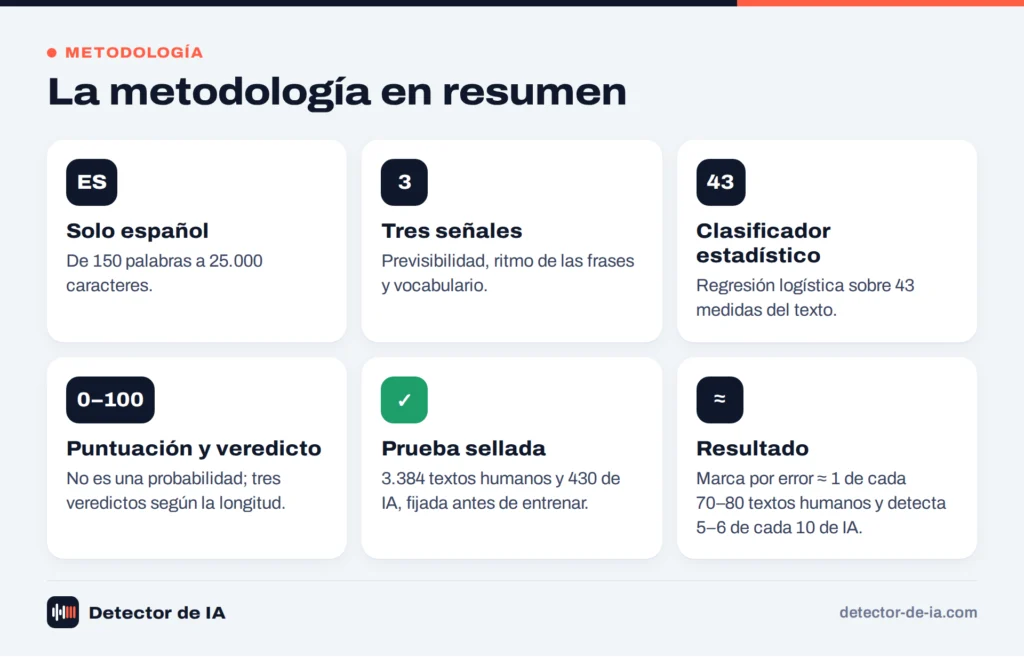
- Solo español. Analiza textos de 150 palabras como mínimo y 25.000 caracteres como máximo.
- Tres señales: la previsibilidad de cada palabra en su contexto, el ritmo de las frases y la variedad del vocabulario.
- Un clasificador estadístico (una regresión logística sobre 43 medidas del texto) entrenado con unos 25.000 pasajes escritos por personas y unos 1.900 textos generados por IA, todos en español.
- Una puntuación de 0 a 100, que no es una probabilidad, y uno de tres veredictos: «Probablemente humano», «Incierto» o «Probablemente IA», con umbrales distintos según la longitud del texto.
- Una prueba sellada de 3.384 textos humanos y 430 de IA, fijada y registrada con una huella digital antes de entrenar, y abierta una sola vez, en septiembre de 2026.
- Resultado: marca por error alrededor de 1 de cada 70 u 80 textos humanos y detecta entre 5 y 6 de cada 10 textos de IA. Deja pasar cerca de la mitad a propósito, para que las acusaciones falsas sean raras.
Qué analizamos (y qué no)
El detector se fija en cómo está escrito un texto, no en lo que dice. No juzga si el contenido es verdadero, original o interesante, ni si está bien argumentado. Examina rasgos estadísticos de la redacción: qué palabras se eligen, con qué regularidad se construyen las frases y cuánta variedad hay en el vocabulario.
Trabaja siempre sobre el texto completo. No divide el texto en frases para puntuarlas por separado, no resalta ni colorea fragmentos y no reparte el texto en un «% IA» y un «% humano». Si sospechas de una parte concreta, por ejemplo la introducción de un trabajo, puedes analizarla por separado siempre que tenga al menos 150 palabras.
Tampoco compara el texto con fuentes externas. Eso es lo que hace un detector de plagio, que es una herramienta distinta: si alguien copia un párrafo escrito por una persona en una enciclopedia, nuestro detector lo verá como escritura humana, porque lo es. Explicamos la diferencia en la guía detector de IA vs detector de plagio.
Los datos: de dónde salen los textos
Un detector aprende de lo que ve, así que lo primero que hay que contar es con qué textos se construyó. Para entrenar el clasificador usamos unos 25.000 pasajes en español escritos por personas y unos 1.900 textos en español generados por IA. Aparte, y sin mezclarse con ellos, reservamos la prueba sellada que describimos en la sección siguiente.
Textos humanos y sus licencias
Todos los textos humanos proceden de fuentes públicas cuyas licencias permiten reutilizarlos. No usamos ningún conjunto de datos con licencia no comercial.
| Fuente | Qué aporta | Licencia |
|---|---|---|
| Wikipedia en español (volcado de 2022) | Prosa enciclopédica, formal y revisada por la comunidad | CC BY-SA |
| Europarl | Actas de los debates del Parlamento Europeo en español | Aviso de reutilización del Parlamento Europeo |
| BOE | Textos legales y administrativos | Reutilización con atribución de la fuente |
| Proyecto Gutenberg | Literatura clásica en español | Dominio público |
| FineWeb-2 (texto web de 2013 a 2021) | Páginas web variadas: blogs, foros, tiendas, noticias | ODC-By |
Esta mezcla tiene un sesgo que conviene conocer. Casi todo el texto humano es anterior a 2022, es decir, anterior a la llegada masiva de los chatbots, lo que reduce el riesgo de que se cuele texto de IA entre los ejemplos «humanos». A cambio, abundan los registros formales: enciclopedia, parlamento, boletín oficial y literatura. La web aporta la parte más informal. Y hay una ausencia importante: no hay redacciones ni trabajos de estudiantes escritos por personas. Volvemos sobre ello en las limitaciones.
Textos generados por IA
Los textos de IA se generaron con modelos de seis familias: Claude, DeepSeek, Gemini, Gemma, gpt-oss (los modelos de pesos abiertos de OpenAI) y Qwen. Cubren 13 géneros, desde redacciones de estudiantes y párrafos académicos hasta cartas de presentación y publicaciones para redes sociales, y cinco variedades del español: de España, de México, de Argentina, de Colombia y un español neutro.
No publicamos tasas de detección por familia ni por modelo. Con muestras pequeñas por familia, esas cifras serían demasiado inestables para sacar conclusiones y darían pie a comparaciones que los datos no sostienen. Por la misma razón, el detector no dice qué chatbot escribió un texto: no está diseñado para eso.
Cómo sellamos la prueba
Medir un detector con los mismos textos con los que se ajustó es la forma más fácil de engañarse a uno mismo: los resultados salen mejores de lo que serán con textos nuevos. Para evitarlo, antes de entrenar nada apartamos un conjunto de textos de prueba y lo sellamos en cuatro pasos:
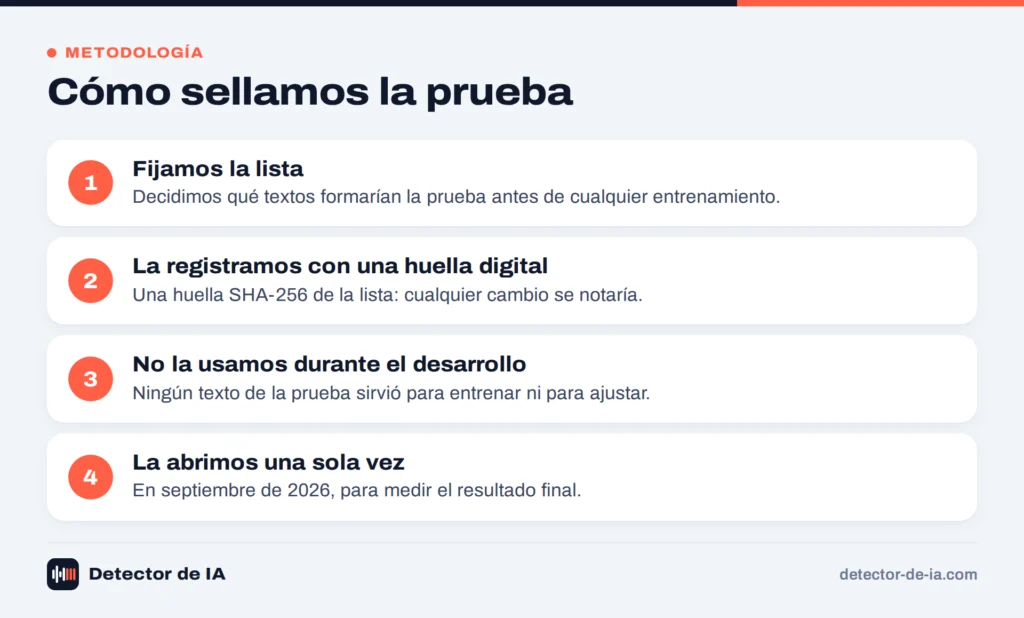
- Fijamos la lista. Decidimos qué textos formarían la prueba antes de cualquier entrenamiento.
- La registramos con una huella digital. Calculamos una huella SHA-256 de la lista, de modo que cualquier cambio posterior (añadir, quitar o sustituir un texto) sería detectable.
- No la usamos durante el desarrollo. Ningún texto de la prueba sirvió para entrenar el clasificador ni para ajustar sus umbrales.
- La abrimos una sola vez. En septiembre de 2026 evaluamos el detector sobre la prueba una única vez y publicamos lo que salió, sin repetir la medición con otras configuraciones hasta obtener cifras más favorables.
Qué contiene la prueba sellada
| Tipo de texto | Fuente | Textos |
|---|---|---|
| Humano | Web (la mitad, de dominios latinoamericanos) | 2.100 |
| Humano | Wikipedia | 450 |
| Humano | Europarl | 360 |
| Humano | BOE | 240 |
| Humano | Proyecto Gutenberg | 234 |
| Total humano | 3.384 | |
| IA | Seis familias de modelos, 13 géneros y cinco variedades del español | 430 |
Los textos se reparten en tres tramos de longitud: de 150 a 299 palabras, de 300 a 599 y de 600 o más. En cada tramo hay unos 1.130 textos humanos, de los cuales 700 son texto web informal, y entre 135 y 152 textos de IA. Medir por tramos importa porque un texto corto ofrece menos señal que uno largo y los errores no se reparten igual.
Las tres señales que mide
Sobre el texto completo, el detector calcula tres señales. Son las mismas que aparecen en la sección «¿Por qué?» del resultado, y cada una se compara con la de textos humanos y de IA en español de la misma longitud.
| Señal | Qué mide | Por qué es relevante |
|---|---|---|
| Previsibilidad | Qué tan previsible es cada palabra en su contexto, según un modelo de lenguaje en español | Los textos de IA tienden a elegir las palabras más esperables; la escritura humana incluye más elecciones sorprendentes |
| Ritmo de las frases | Cuánto varía la longitud de las frases a lo largo del texto | Las personas mezclan frases cortas y largas; la IA suele mantener una longitud más uniforme |
| Vocabulario | Variedad de las palabras que usa el texto | La variedad léxica de los textos de IA tiende a diferir de la de los textos humanos de la misma longitud |
La previsibilidad está relacionada con la perplejidad, una medida clásica de cuánto «sorprende» un texto a un modelo de lenguaje. Para calcularla usamos un modelo de lenguaje en español: cuanto más previsibles son las palabras elegidas, más se parece el texto a lo que produciría una máquina que tiende a escoger la opción más probable.
Ninguna señal prueba nada por sí sola. Una persona puede escribir frases muy regulares en un informe técnico, y una IA puede elegir de vez en cuando una palabra inesperada. Lo que pesa es la coincidencia: cuando varias señales apuntan en la misma dirección, la puntuación sube; cuando solo una lo hace levemente y el resto del texto es variado, la puntuación se mantiene baja.
El clasificador y la puntuación de 0 a 100
Las señales se combinan en un clasificador estadístico: una regresión logística que pondera 43 medidas numéricas del texto, entre ellas las de previsibilidad, ritmo y vocabulario. Es un modelo deliberadamente sencillo. Aprende cuánto debe pesar cada medida a partir de los ejemplos humanos y de IA del entrenamiento, y es más fácil de revisar que un modelo opaco.
El resultado es una puntuación de 0 a 100. No es una probabilidad ni el porcentaje del texto escrito por IA: una puntuación de 70 no significa «70 % de probabilidad de IA» ni «el 70 % del texto es de IA». Indica cuánto se parece el conjunto de señales del texto al de los textos de IA con los que se entrenó el clasificador; cuanto más alta, mayor el parecido.
El detector no ofrece un «nivel de confianza» aparte. La incertidumbre forma parte del propio veredicto, y para eso existe la zona «Incierto».
Umbrales por tramo de longitud
La puntuación se traduce en un veredicto con umbrales distintos según la longitud del texto, porque un texto de 200 palabras y uno de 1.000 no se comportan igual:
| Longitud del texto | «Incierto» desde | «Probablemente IA» desde |
|---|---|---|
| 150 a 299 palabras | 55 | 95 |
| 300 a 599 palabras | 40 | 98 |
| 600 palabras o más | 27 | 96 |
Por debajo del umbral de «Incierto», el veredicto es «Probablemente humano». Un ejemplo: una puntuación de 50 queda en «Incierto» en un texto de 400 palabras y también en uno de 700, pero en un texto de 200 palabras corresponde a «Probablemente humano».
Los umbrales de «Probablemente IA» son muy altos a propósito. Preferimos que el detector calle ante un texto de IA antes que acusar a una persona: una acusación falsa puede tener consecuencias serias para un estudiante o un profesional, mientras que un texto de IA no detectado puede descubrirse por otras vías. El precio de esa elección es claro y se ve en los resultados: el detector deja pasar cerca de la mitad de los textos de IA.
Resultados de la prueba sellada
Estas son las cifras que obtuvimos al abrir la prueba sellada, y son las únicas cifras de precisión que publicamos sobre nuestro detector. Cuentan como «marcados» o «detectados» los textos que recibieron el veredicto «Probablemente IA». Entre corchetes va el intervalo de confianza del 95 %: el rango de valores compatible con lo observado, dado el tamaño de la muestra.
| Longitud | Textos humanos marcados como IA (todos) | Texto web informal marcado como IA | Textos de IA detectados |
|---|---|---|---|
| 150 a 299 palabras | 1,24 % [0,74–2,07] 14 de 1.130 (≈ 1 de cada 80) | 1,43 % [0,78–2,61] 10 de 700 (≈ 1 de cada 70) | 53,3 % [45,4–61,0] 81 de 152 (≈ 5 de cada 10) |
| 300 a 599 palabras | 1,24 % [0,74–2,07] 14 de 1.130 (≈ 1 de cada 80) | 1,57 % [0,88–2,79] 11 de 700 (≈ 1 de cada 65) | 48,1 % [39,9–56,5] 65 de 135 (≈ 5 de cada 10) |
| 600 palabras o más | 1,42 % [0,88–2,30] 16 de 1.124 (≈ 1 de cada 70) | 1,86 % [1,09–3,15] 13 de 700 (≈ 1 de cada 55) | 63,6 % [55,5–71,1] 91 de 143 (≈ 6 de cada 10) |
Falsas alarmas: textos humanos marcados como IA
Sobre el conjunto de textos humanos, el detector marcó como IA entre el 1,24 % y el 1,42 % según el tramo: alrededor de 1 de cada 70 u 80 textos. En el texto web informal (blogs, foros, tiendas, webs de noticias) la tasa sube un poco, hasta el 1,86 % en los textos de 600 palabras o más, es decir, cerca de 1 de cada 55. Incluso en el peor extremo de los intervalos, las falsas alarmas se mantienen por debajo del 3,2 %. No es cero, y por eso ningún resultado debe usarse como prueba única.
Textos humanos marcados como IA por error
Ver los datos
| Longitud | Todos los textos humanos | Textos informales |
|---|---|---|
| 150–299 palabras | 1,2 % (14 de 1.130) | 1,4 % (10 de 700) |
| 300–599 palabras | 1,2 % (14 de 1.130) | 1,6 % (11 de 700) |
| 600 o más | 1,4 % (16 de 1.124) | 1,9 % (13 de 700) |
Detección: textos de IA reconocidos
El detector reconoció el 53,3 % de los textos de IA de 150 a 299 palabras, el 48,1 % de los de 300 a 599 y el 63,6 % de los de 600 o más. Dicho de otro modo: cerca de la mitad de los textos de IA recibe «Incierto» o «Probablemente humano». Un resultado «Probablemente humano» no demuestra que un texto lo haya escrito una persona.
Textos de IA detectados por longitud
Ver los datos
| Longitud | Detectados | IC 95 % | Textos |
|---|---|---|---|
| 150–299 palabras | 53,3 % | 45,4 %–61,0 % | 81 de 152 |
| 300–599 palabras | 48,1 % | 39,9 %–56,5 % | 65 de 135 |
| 600 o más | 63,6 % | 55,5 %–71,1 % | 91 de 143 |
Los intervalos de la detección son más anchos que los de las falsas alarmas, de unos 16 puntos, porque cada tramo tiene entre 135 y 152 textos de IA frente a más de 1.100 humanos. La tasa real en el tramo de 300 a 599 palabras, por ejemplo, podría estar entre el 39,9 % y el 56,5 %. Por eso lo resumimos como «5 de cada 10» o «6 de cada 10» y no como una cifra exacta.
Capacidad de separación
Otra forma de medir un detector es el AUC: la probabilidad de que, tomando al azar un texto de IA y uno humano, el de IA obtenga una puntuación más alta. En la prueba sellada, el AUC fue de 0,95 a 0,96 en cada tramo. La puntuación ordena bien los textos; los umbrales altos son una decisión de prudencia, no una incapacidad para ver diferencias.
Estas cifras proceden de una prueba propia, no de una evaluación independiente. La diseñamos para que fuera difícil engañarnos, pero no sustituye a una auditoría externa. Si quieres compararlas con las de otros detectores, recuerda que cada fabricante mide con textos y criterios distintos; lo explicamos en qué tan preciso es un detector de IA en español.
Dónde funciona peor
La prueba sellada también mostró en qué tipos de texto el detector acierta mucho menos. Entre los textos de IA, estos se detectaron con bastante menos frecuencia que la media:
- Cartas de presentación. Son textos convencionales y formulaicos incluso cuando los escribe una persona, así que probablemente la diferencia entre ambos se reduce.
- Publicaciones para redes sociales. Suelen ser cortas, informales y fragmentadas, lo que deja poca señal que medir.
- Párrafos académicos. El registro académico en español ya es regular y previsible por naturaleza.
- Redacciones cortas de estudiantes. Un caso especialmente delicado, porque es justo donde más se usa un detector.
Si trabajas con estos tipos de texto, un «Probablemente humano» dice todavía menos de lo habitual. Lo mismo ocurre, previsiblemente, con textos de IA editados a mano o pasados por un parafraseador, que alteran justo las señales que medimos; lo tratamos en la guía sobre humanizadores de IA.
Qué muestra el resultado
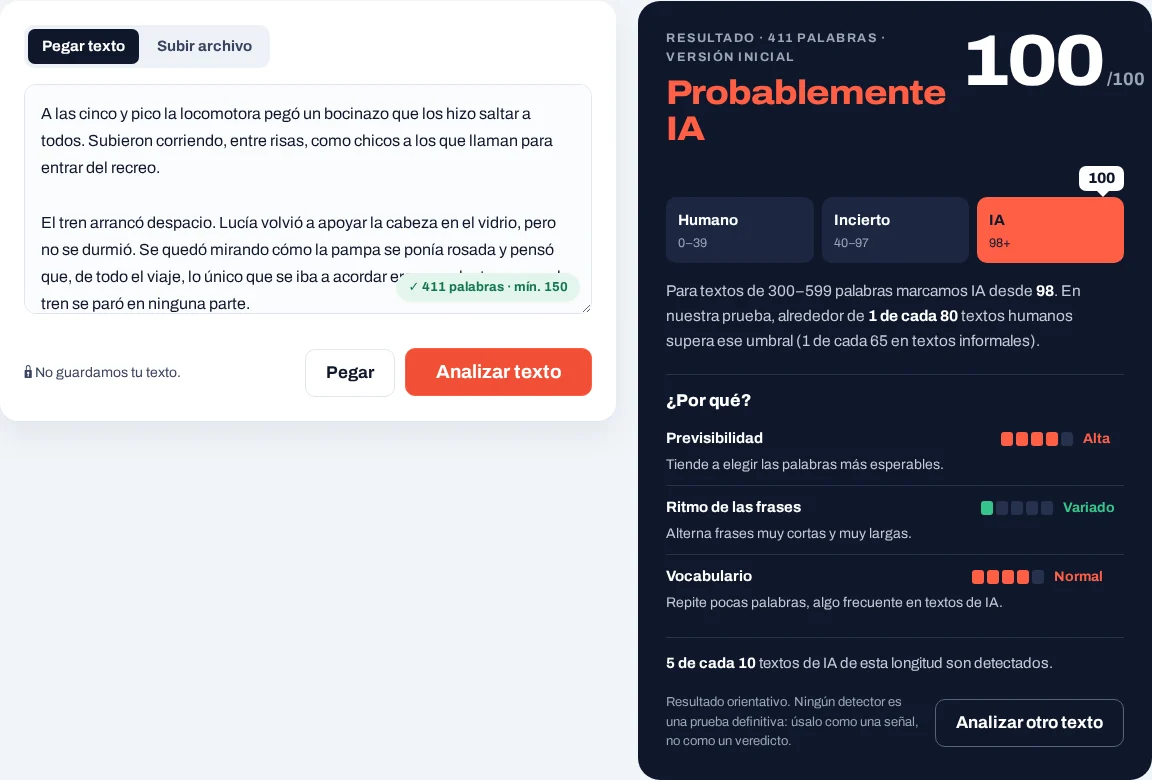
Cuando pegas un texto o subes un archivo y pulsas «Analizar texto», el resultado muestra:
- Puntuación de 0 a 100: el indicador principal. No es una probabilidad ni el porcentaje de palabras escritas por IA.
- Veredicto: «Probablemente humano», «Incierto» o «Probablemente IA», según la zona que corresponde a la longitud de tu texto.
- Barra de zonas: muestra dónde cae tu puntuación respecto a los umbrales de tu tramo.
- Sección «¿Por qué?»: las tres señales (Previsibilidad, Ritmo de las frases y Vocabulario), cada una situada en una escala de 5 pasos entre el texto humano típico y el texto de IA típico de la misma longitud.
- Frase de umbrales: indica a partir de qué puntuación empiezan «Incierto» y «Probablemente IA» para la longitud de tu texto.
- Datos de detección: una línea que recuerda lo que midió la prueba sellada, para que no leas el resultado como una certeza.
- Aviso de «versión inicial»: el detector se presenta como una primera versión, y el resultado debe tomarse como una orientación.
Para aprender a leer cada parte con ejemplos, consulta cómo interpretar un resultado del detector de IA y el informe de ejemplo.
Qué no hace el detector
Ser claros sobre lo que la herramienta no puede hacer es tan importante como explicar lo que sí hace:
- No identifica al autor. No dice qué chatbot generó un texto ni quién lo escribió o con qué intención.
- No analiza frase por frase. No resalta ni colorea frases concretas.
- No da porcentajes de «IA» y «humano» ni un nivel de confianza.
- No analiza otros idiomas. Si pegas un texto en otro idioma, lo rechaza con el aviso «Este detector solo analiza textos en español». No hay selector de idioma.
- No analiza textos de menos de 150 palabras. Con menos material, las señales no son lo bastante estables.
- No evalúa calidad, veracidad ni originalidad, y no detecta plagio.
- No guarda tu texto. Lo explicamos en la sección de privacidad.
Desaconsejamos usar cualquier detector, incluido el nuestro, como única base para decisiones disciplinarias. Un «Probablemente IA» es un motivo para revisar con más contexto, no una conclusión.
Limitaciones
Estas son las limitaciones que conocemos de la versión actual. Las enumeramos todas, aunque algunas ya han salido antes, porque son lo primero que debería tener en cuenta quien use el resultado:
- Es una versión inicial. El propio resultado lo indica. Esperamos mejorarlo, y publicaremos nuevas mediciones cuando cambie.
- Géneros difíciles. Detecta mucho peor las cartas de presentación, las publicaciones para redes sociales, los párrafos académicos y las redacciones cortas de estudiantes.
- Solo español. No sirve para textos en otros idiomas ni para textos que mezclan idiomas de forma sustancial.
- Mínimo de 150 palabras. Y un máximo de 25.000 caracteres. En los textos más cortos del rango, la detección es la más baja. Más detalles en nuestra guía sobre textos cortos.
- Datos humanos antiguos y formales. La mayor parte del texto humano es web anterior a 2022 o procede de registros formales. La escritura más reciente, muy coloquial o de nichos especializados está menos representada.
- Sin redacciones de estudiantes humanos. Entre los datos humanos no hay trabajos escolares ni universitarios escritos por personas. Las falsas alarmas medidas en la web y en textos formales no tienen por qué ser iguales en redacciones de estudiantes, así que en contextos educativos hay que ser todavía más prudente.
- Prueba propia y muestras pequeñas de IA. La prueba sellada no es una evaluación independiente, y con 430 textos de IA los intervalos de la detección son anchos.
- Los modelos cambian. Los textos de modelos futuros, o de familias que no incluimos, pueden comportarse de otra forma.
Si te preocupa que un texto humano reciba un resultado alto, nuestra guía de falsos positivos en detectores de IA explica por qué ocurre y qué hacer.
Por qué el resultado es orientativo
Nos preguntan a menudo por qué no damos un «sí» o un «no» definitivo. La respuesta tiene tres partes.
Primero, los modelos de IA avanzan constantemente. Cada nueva generación escribe de forma más natural y las huellas estadísticas que busca un detector se vuelven más leves. Es una carrera continua en la que no se puede garantizar certeza absoluta.
Segundo, el lenguaje humano es variable. No existe una única forma de escribir como una persona: hay quien escribe con una formalidad que recuerda a la IA, y hay textos de IA a los que se les pide sonar coloquiales. En esas zonas grises siempre hay un margen de error, y por eso hablamos de falsos positivos y falsos negativos como riesgos reales.
Tercero, los datos de entrenamiento tienen límites. Ningún conjunto de referencia cubre toda la riqueza del idioma. Estilos nuevos, jergas especializadas o variedades poco representadas pueden generar más incertidumbre en la clasificación. Por eso el resultado es una estimación informada, no una prueba forense.
Por qué un detector solo para español
Muchos detectores se desarrollaron primero para inglés, y al aplicarlos al español los resultados pueden ser inconsistentes. El español tiene rasgos que afectan a la detección: frases más largas y con más subordinación, conectores formales frecuentes en textos académicos, una morfología verbal rica que permite omitir el sujeto y variaciones regionales importantes. Un detector genérico puede confundir esos rasgos normales con señales de IA.
Por eso nuestro detector solo analiza español: mide la previsibilidad con un modelo de lenguaje en español, compara cada texto con textos en español de la misma longitud y se entrenó solo con textos en español. Los textos de IA cubren variedades de España, México, Argentina y Colombia, además de un español neutro, y en la prueba sellada la mitad del texto web procede de dominios latinoamericanos. Eso no lo hace perfecto, pero sí más adecuado que una herramienta pensada para otro idioma. Lo explicamos con más detalle en detector de IA en español vs inglés.
Privacidad
El texto se procesa en nuestros propios servidores, no se guarda, no se comparte con terceros y no se usa para entrenar el detector. Si subes un archivo .txt, .docx o .pdf (de hasta 5 MB), se lee en tu navegador y el archivo no se sube: solo se envía el texto para analizarlo. Los detalles están en nuestra política de privacidad.
Cómo usar el resultado con responsabilidad
- Úsalo como punto de partida. Un resultado alto justifica una conversación o una revisión, no una sanción.
- Mira la longitud y el tipo de texto. En textos cortos y en los géneros difíciles, el resultado dice menos.
- Busca otras pruebas. Borradores, historial de versiones, notas o una conversación sobre el contenido dicen más que cualquier puntuación.
- Ten en cuenta a quién escribe. Estilos muy formales o regulares pueden acercarse a los patrones de la IA sin serlo.
Si eres docente, nuestra guía para profesores propone un protocolo de revisión. Si te han acusado de usar IA sin haberlo hecho, lee la guía para estudiantes acusados injustamente.
Conclusión
Nuestro detector no es una bola de cristal. Es un analizador estadístico que examina cómo está escrito un texto en español, lo compara con textos humanos y de IA de la misma longitud y da una puntuación orientativa de 0 a 100 con un veredicto prudente. Sabemos cuánto se equivoca porque lo medimos en una prueba sellada, y publicamos esas cifras con sus márgenes de error. Úsalo como un indicio más, junto con el criterio humano y el contexto, sobre todo cuando la decisión afecta a una persona. Puedes probar el detector gratis y sin registro con cualquier texto en español de al menos 150 palabras.
Si tienes más preguntas, revisa nuestras preguntas frecuentes o conoce más sobre el proyecto en sobre nosotros.
Preguntas frecuentes
¿La puntuación de 0 a 100 es una probabilidad de que el texto sea de IA?
No. La puntuación indica cuánto se parece el conjunto de señales del texto (previsibilidad, ritmo de las frases y vocabulario) al de los textos de IA con los que se entrenó el clasificador. No es una probabilidad ni el porcentaje del texto escrito por IA. Lo que importa es el veredicto: «Probablemente humano», «Incierto» o «Probablemente IA», con umbrales distintos según la longitud del texto.
¿Con qué frecuencia marca como IA un texto escrito por una persona?
En nuestra prueba sellada, alrededor de 1 de cada 80 textos humanos de 150 a 599 palabras (1,24 %, intervalo de confianza del 95 %: 0,74–2,07 %) y 1 de cada 70 de 600 palabras o más (1,42 %, 0,88–2,30 %). En texto web informal la tasa sube un poco: entre 1 de cada 70 y 1 de cada 55 (de 1,43 % a 1,86 %). No es cero, así que ningún resultado debe usarse como prueba única.
¿Cuántos textos de IA detecta?
Unos 5 de cada 10 en textos de 150 a 299 palabras (53,3 %, intervalo de confianza del 95 %: 45,4–61,0 %) y de 300 a 599 palabras (48,1 %, 39,9–56,5 %), y unos 6 de cada 10 en textos de 600 palabras o más (63,6 %, 55,5–71,1 %). Deja pasar cerca de la mitad a propósito, para que las acusaciones falsas sean raras.
¿Qué es la prueba sellada?
Es el conjunto de textos con el que medimos el detector: 3.384 textos humanos (web, Wikipedia, Europarl, BOE y Proyecto Gutenberg) y 430 textos de IA. La lista se fijó y se registró con una huella SHA-256 antes de cualquier entrenamiento, ningún texto se usó para desarrollar el detector y la prueba se abrió una sola vez, en septiembre de 2026. Es una prueba propia, no una evaluación independiente.
¿Con qué textos se entrenó el detector?
Con unos 25.000 pasajes en español escritos por personas, procedentes de Wikipedia (CC BY-SA), Europarl, el BOE, el Proyecto Gutenberg (dominio público) y texto web de FineWeb-2 (ODC-By), y con unos 1.900 textos en español generados por modelos de las familias Claude, DeepSeek, Gemini, Gemma, gpt-oss y Qwen. No usamos datos con licencia no comercial.
¿Funciona con textos cortos o en otros idiomas?
No. Solo analiza textos en español de al menos 150 palabras y como máximo 25.000 caracteres. Además, detecta peor las cartas de presentación, las publicaciones para redes sociales, los párrafos académicos y las redacciones cortas de estudiantes, así que en esos casos el resultado debe tomarse con más cautela.
¿Mi texto queda guardado después de analizarlo?
No. El texto se procesa en nuestros propios servidores, no se guarda, no se comparte y no se usa para entrenar el detector. Puedes consultar los detalles en nuestra política de privacidad.