Si buscas saber qué tan preciso es un detector de IA cuando analiza texto en español, la respuesta honesta es: no lo sabemos con certeza. No existe en 2026 un benchmark independiente a gran escala que mida la precisión de los detectores de IA específicamente en español. Lo que sí sabemos, a partir de pruebas parciales, datos de fabricantes y evidencia indirecta, es que la precisión es probablemente inferior a la del inglés — pero cuantificar esa brecha con exactitud no es posible con la evidencia disponible.
Este artículo reúne todo lo que sabemos y, con igual importancia, todo lo que no sabemos sobre la precisión de los detectores de IA en español. Cada dato se presenta con su nivel de evidencia: si proviene de un estudio académico, de una prueba independiente, de una afirmación del fabricante, o de nuestra propia inferencia. Creemos que esta transparencia es más útil que presentar cifras con una confianza que los datos no justifican.
Contenido
- El problema: casi todos los detectores se diseñaron para inglés
- Lo que sabemos vs lo que los fabricantes afirman
- ¿Por qué los detectores rinden peor en español?
- El caso especial: hispanohablantes que escriben en inglés
- Turnitin y el español: avances reales con limitaciones claras
- Recomendaciones prácticas
- Lo que no sabemos
- Preguntas frecuentes
El problema: casi todos los detectores se diseñaron para inglés
Este es un hecho bien establecido, no una suposición: la inmensa mayoría de los detectores de IA fueron entrenados con conjuntos de datos predominantemente en inglés. El español, a pesar de ser el cuarto idioma más hablado del mundo con más de 500 millones de hablantes, está subrepresentado en los datasets de entrenamiento de la mayoría de herramientas de detección. Esto crea un desequilibrio fundamental: los modelos aprenden a reconocer los patrones «normales» de la escritura en inglés, pero carecen de datos equivalentes para otros idiomas.
A partir de la evidencia disponible — que combina pruebas independientes limitadas, datos de fabricantes y resultados informales — estimamos que la precisión de los detectores es menor en español que en inglés. Sin embargo, no existen datos suficientes para cuantificar esa brecha con precisión. Las cifras que circulan en el sector mezclan afirmaciones de fabricantes (que tienden al optimismo) con pruebas independientes (que suelen mostrar resultados significativamente peores).
Un dato que pone en perspectiva la fiabilidad de las afirmaciones del sector: en 2025, la Comisión Federal de Comercio de Estados Unidos (FTC) aprobó una orden definitiva contra la empresa Workado (antes Content at Scale), que anunciaba su detector de IA como «98% preciso». Según la denuncia administrativa de la FTC, pruebas independientes mostraron una precisión del 53% en contenido de uso general: en palabras de la propia agencia, no mejor que lanzar una moneda al aire. Este caso demuestra que las afirmaciones de precisión en la industria de detección de IA requieren verificación independiente, no confianza ciega.
Lo que sabemos vs lo que los fabricantes afirman
La diferencia entre lo que los fabricantes anuncian y lo que las pruebas independientes muestran es, posiblemente, la información más relevante de este análisis. Los fabricantes suelen anunciar precisiones muy altas, medidas con sus propios textos y criterios. Las evaluaciones independientes, cuando existen, tienden a obtener resultados más bajos en condiciones del mundo real, con textos editados, parafraseados o de géneros distintos a los del entrenamiento. El caso Workado muestra hasta dónde puede llegar esa brecha. Es razonable pensar que se amplía en español, aunque su magnitud no ha sido medida de forma rigurosa.
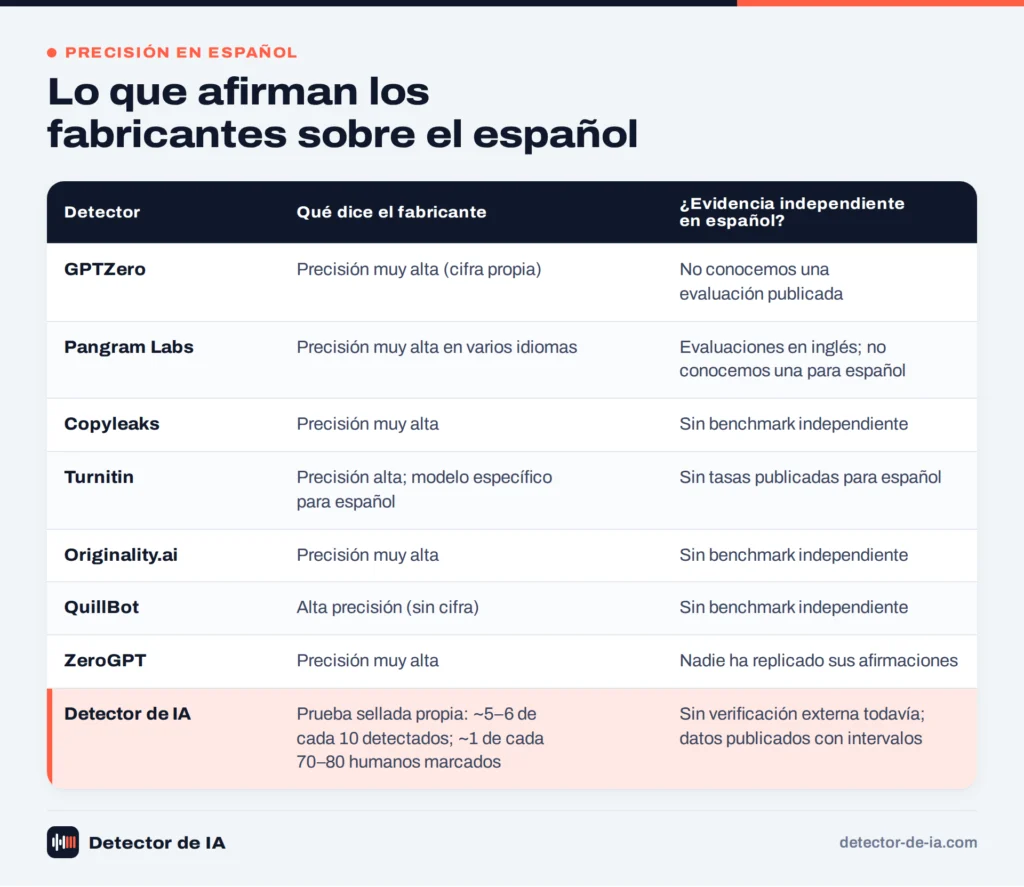
| Detector | Qué dice el fabricante | Soporte de español | Qué se sabe de forma independiente para español |
|---|---|---|---|
| GPTZero | Precisión muy alta (cifra del propio fabricante) | Consultar la documentación del fabricante | No conocemos una evaluación independiente publicada para español |
| Pangram Labs | Precisión muy alta en varios idiomas | Tokenizador dedicado por idioma, según el fabricante | Hay evaluaciones académicas publicadas en inglés; no conocemos una específica para español |
| Copyleaks | Precisión muy alta | Varios idiomas, según el fabricante | Sin benchmark independiente para español |
| Turnitin | Precisión alta en su documentación | Modelo específico para español, separado del inglés | Modelo documentado por Turnitin, entrenado con versiones anteriores de ChatGPT; sin tasas publicadas para español |
| Originality.ai | Precisión muy alta | Multilingüe, según el fabricante | Sin benchmark independiente para español |
| QuillBot | Alta precisión (sin cifra) | Español soportado, según el fabricante | Sin benchmark independiente para español |
| Detector de IA | Prueba sellada propia (no independiente): ~5-6 de cada 10 textos de IA detectados; ~1 de cada 70-80 textos humanos marcados por error | Solo español: modelo de lenguaje en español + clasificador calibrado por longitud | Sin verificación externa todavía; publicamos nuestros datos con sus intervalos de confianza |
| ZeroGPT | Precisión muy alta | Sin información clara | Sin benchmark independiente; ningún tercero conocido ha replicado sus afirmaciones |
Qué dice cada fabricante frente a lo que se sabe de forma independiente para español. No reproducimos cifras de precisión de otras herramientas sin una fuente pública que podamos enlazar; la información sobre soporte de idiomas procede de lo que declaran los propios fabricantes. No existe un benchmark independiente a gran escala para español.
Varios puntos merecen atención. Primero, las cifras de precisión que anuncian los fabricantes se obtienen con sus propios textos y criterios, y no son comparables entre sí ni con las de una evaluación independiente. Segundo, las evaluaciones independientes que se publican se hacen casi siempre en inglés: para español, la evidencia es aún más fragmentaria, y que un fabricante declare soporte para un idioma no dice nada de su precisión en ese idioma. Para una comparativa más amplia, consulta nuestra guía de los mejores detectores. Para entender cómo interpretar los resultados, visita cómo interpretar el resultado.
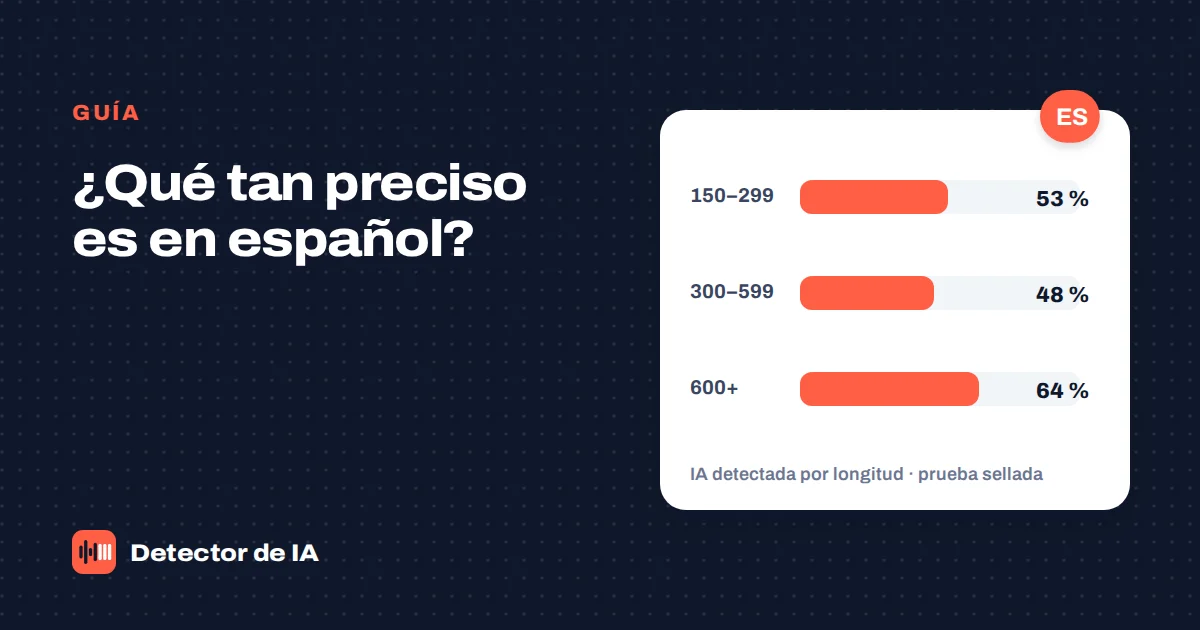
En cuanto a nuestra propia herramienta, somos transparentes: no hemos sido sometidos a un benchmark independiente externo. Nuestro detector usa un modelo de lenguaje en español y un clasificador entrenado con textos en español escritos por personas y generados por IA, con zonas de resultado calibradas por longitud. Lo que sí publicamos son los resultados de nuestra propia prueba sellada (3.384 textos humanos y 430 de IA; la lista se fijó y se registró con una huella SHA-256 antes de entrenar, y se abrió una sola vez, en septiembre de 2026), que no sustituye a una evaluación independiente: marcó por error como IA alrededor de 1 de cada 80 textos humanos de 150 a 599 palabras (1,24 %; intervalo de confianza del 95 %: 0,74–2,07 %) y 1 de cada 70 de 600 o más (1,42 %; 0,88–2,30 %) —en texto web informal, entre 1 de cada 70 y 1 de cada 55 (del 1,43 % al 1,86 %)—, y detectó unos 5 de cada 10 textos de IA de 150 a 299 palabras (53,3 %; 45,4–61,0 %) y de 300 a 599 (48,1 %; 39,9–56,5 %), y unos 6 de cada 10 de 600 o más (63,6 %; 55,5–71,1 %). Es decir, deja pasar cerca de la mitad de los textos de IA, a propósito, para que las acusaciones falsas sean raras. Hasta que una evaluación externa verifique su rendimiento, son datos propios, no un benchmark independiente. Consideramos que esta honestidad es más valiosa que anunciar una precisión sin verificación — precisamente el comportamiento que la FTC ha empezado a sancionar. Más sobre cómo funciona nuestro sistema en nuestra metodología.
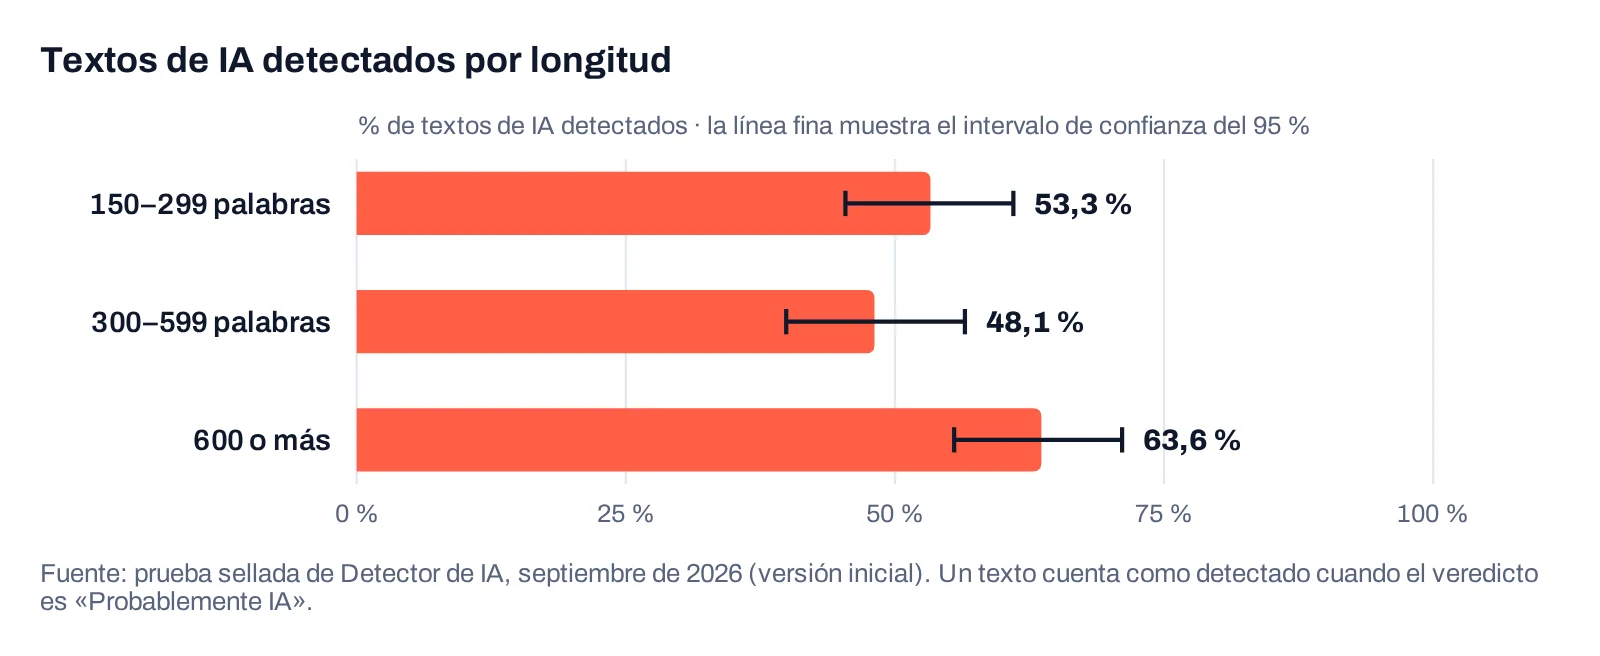
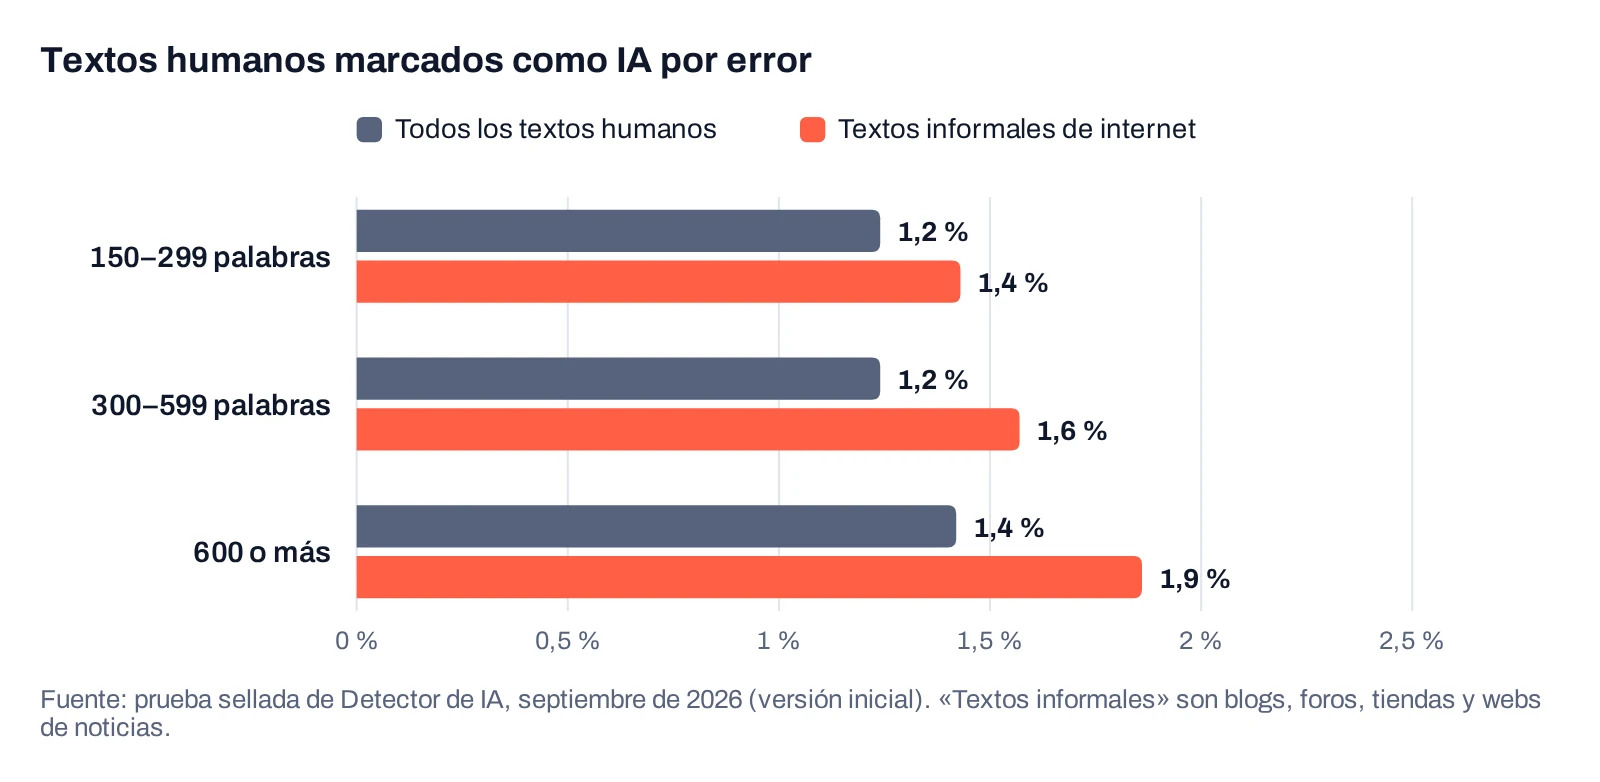
Dos matices para leer bien esas cifras. Cuentan como detectados los textos que recibieron el veredicto «Probablemente IA»: un texto de IA que queda en «Incierto» no se cuenta como detectado. Y la prueba mostró puntos débiles claros: las cartas de presentación, las publicaciones para redes sociales, los párrafos académicos y las redacciones cortas de estudiantes se detectan mucho menos. Los intervalos de la detección son anchos (unos 16 puntos) porque hay entre 135 y 152 textos de IA por tramo; por eso hablamos de «5 de cada 10» y no de una cifra exacta. Si quieres comprobar cómo responde con tus propios textos, puedes probar el detector gratis.
¿Por qué los detectores rinden peor en español? Lo que la evidencia sugiere
Las razones por las que los detectores probablemente rinden peor en español tienen bases lingüísticas sólidas, aunque su impacto cuantitativo en la detección no ha sido medido directamente. El factor más determinante es el desequilibrio en los datos de entrenamiento: menos datos de entrenamiento en español significa menos capacidad del modelo para distinguir patrones legítimos de patrones artificiales en ese idioma. Este es un hecho técnico bien establecido en el campo del procesamiento de lenguaje natural.
A nivel lingüístico, el español tiene características estadísticas que probablemente alteran las señales que miden los detectores, aunque no existen estudios que cuantifiquen el impacto exacto en la precisión de detección. La perplejidad opera de forma diferente en español: las conjugaciones verbales más ricas, la flexión de género y número, y el orden de palabras más flexible crean un perfil de perplejidad distinto al del inglés. La variabilidad (burstiness) también difiere: la prosa académica en español tiende a usar oraciones más largas y complejas, con mayor uso de cláusulas subordinadas. Estos factores probablemente hacen que los umbrales calibrados para inglés no sean transferibles al español.
El español académico utiliza además expresiones formulistas («cabe señalar que», «se observa que», «a partir de los resultados obtenidos») que se solapan con los patrones que ChatGPT genera en español, creando una zona de ambigüedad que los detectores no resuelven bien. Para entender más sobre estas señales, consulta nuestro artículo sobre detección en español vs inglés y los límites de lo que un detector puede hacer.
Un factor específico que merece mención con su contexto: el parafraseo. Los parafraseadores y los llamados humanizadores cambian precisamente las elecciones de palabras y el ritmo de las frases que miden los detectores, por lo que cabe esperar que reduzcan la detección en cualquier idioma. No conocemos una evaluación amplia y replicada que cuantifique ese efecto en español, así que conviene tratarlo como un riesgo probable, no como una cifra. Lo que sí está claro es que los humanizadores de IA y las herramientas de parafraseo son una forma habitual de intentar evadir la detección, también en español.
El caso especial: hispanohablantes que escriben en inglés
El problema de precisión no se limita a textos escritos en español. Aquí la evidencia es más robusta: un estudio académico publicado por investigadores de Stanford documentó que siete detectores de IA clasificaron erróneamente como IA, en promedio, el 61,2% de los ensayos TOEFL escritos por hablantes no nativos de inglés — ninguno generado por inteligencia artificial. Este dato proviene de un estudio peer-reviewed con metodología replicable, lo que lo sitúa en el nivel más alto de evidencia disponible en este campo.
Esto afecta de lleno a los hispanohablantes que estudian o trabajan en inglés: una sintaxis influida por el español y un vocabulario más limitado en la segunda lengua pueden hacer que un texto propio parezca más previsible para un detector. Lo que denominamos una «doble penalización» — menor precisión de detección en textos EN español combinada con tasas desproporcionadas de falsos positivos para hispanohablantes escribiendo en inglés — es una inferencia nuestra basada en la convergencia de estas dos líneas de evidencia, no un hallazgo medido directamente. Sin embargo, la lógica es consistente y las implicaciones son serias para cualquier hispanohablante en una universidad anglófona. Si has sido acusado injustamente, consulta nuestra guía de defensa para estudiantes.
Turnitin y el español: avances reales con limitaciones claras
Turnitin merece mención aparte porque ha dado un paso que pocos competidores han dado: lanzó un modelo de detección de IA dedicado para español, separado del modelo en inglés. Esta es información confirmada por la documentación oficial de Turnitin. El modelo fue entrenado específicamente con escritura en español, lo que constituye un avance significativo respecto a aplicar un modelo entrenado en inglés a texto en otro idioma.
Sin embargo, la documentación de Turnitin revela una limitación importante: el modelo español fue entrenado únicamente con texto generado por versiones anteriores de los modelos de OpenAI que usa ChatGPT. No incluye las versiones recientes de ChatGPT ni otras familias como Claude, Gemini o DeepSeek, que muchos estudiantes usan en 2026. Es razonable inferir que su capacidad de detección disminuye ante texto generado por modelos más recientes, aunque no se han publicado datos que confirmen esta inferencia directamente. Turnitin tampoco ha publicado tasas de precisión específicas para su modelo español. Para más contexto, consulta nuestra guía completa de Turnitin y nuestra guía sobre detección de texto de ChatGPT.
Recomendaciones prácticas (con las reservas apropiadas)
Basándonos en la evidencia disponible — que, como hemos documentado, es limitada para español — estas son nuestras orientaciones prácticas. No son rankings de precisión porque no existen datos suficientes para establecer uno; son recomendaciones de flujo de trabajo.
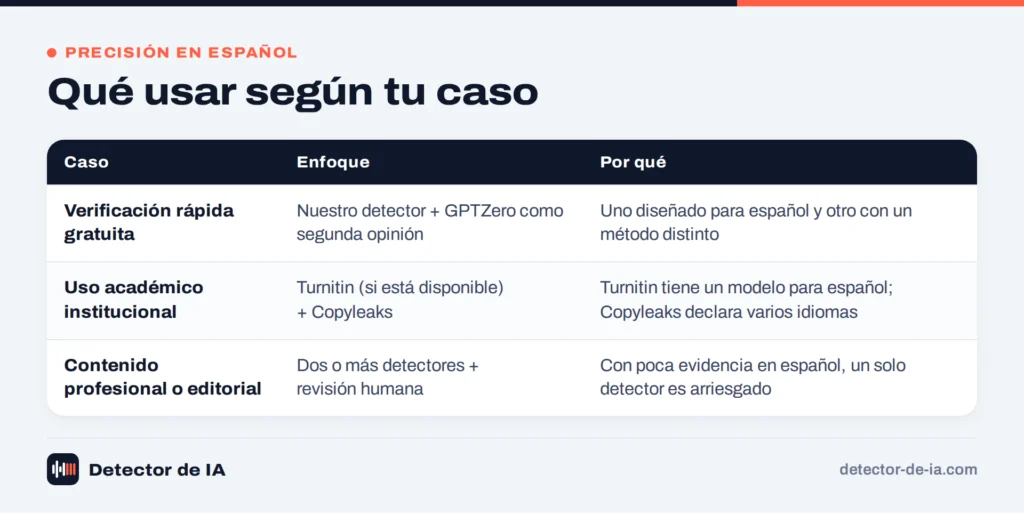
| Caso de uso | Enfoque recomendado | Razonamiento |
|---|---|---|
| Verificación rápida gratuita | Nuestro detector + GPTZero (como segunda opinión) | Nuestra herramienta está diseñada solo para español; una segunda herramienta con otro método aporta una perspectiva distinta, aunque no conocemos datos independientes de GPTZero en español |
| Uso académico institucional | Turnitin (si disponible) + Copyleaks | Turnitin tiene un modelo específico para español; Copyleaks declara soporte para varios idiomas |
| Contenido profesional / editorial | 2+ detectores + revisión humana | La evidencia insuficiente para español hace que la dependencia de un solo detector sea especialmente arriesgada |
Orientaciones prácticas basadas en la evidencia disponible. No constituyen un ranking de precisión.
La recomendación transversal: usa siempre al menos dos detectores para texto en español. La brecha de precisión — que según la evidencia disponible es mayor para español que para inglés — hace que la dependencia de una sola herramienta sea más arriesgada. Un resultado que coincide en dos herramientas diferentes es significativamente más informativo que cualquier porcentaje aislado. Y en todos los casos, la evidencia de proceso (borradores, historial de versiones, notas) es más sólida que cualquier puntuación de un detector. Para documentos extensos, sigue el flujo de trabajo de nuestra guía de detección en PDF. Si eres docente, nuestra guía para profesores incluye un protocolo adaptado.
¿Quieres probar un detector diseñado para español? Nuestro detector de IA es gratuito y no requiere registro, con un límite de uso razonable por conexión. Aunque no ha sido sometido a un benchmark externo independiente, analiza solo textos en español, con un modelo de lenguaje en español y un clasificador entrenado con textos en español. Necesita al menos 150 palabras y devuelve una puntuación de 0 a 100 (no una probabilidad) con uno de tres veredictos: «Probablemente humano», «Incierto» o «Probablemente IA». Consulta nuestro informe de ejemplo para ver cómo funciona el análisis.
Lo que no sabemos (y lo que la industria necesita)
Este artículo ha sido deliberadamente transparente sobre las limitaciones de la evidencia disponible. Estas son las preguntas que siguen sin respuesta en 2026 y que necesitan investigación urgente:
No existe un benchmark independiente a gran escala para español. No conocemos ninguna institución académica ni organismo independiente que haya publicado una evaluación sistemática de la precisión de los detectores de IA específicamente en texto en español, con textos generados por los modelos actuales (las versiones recientes de ChatGPT, Claude o Gemini). No hay datos sobre variedades del español. ¿Rinde igual un detector con español de España que con español de México, Argentina o Colombia? No lo sabemos. Nuestra prueba sellada incluye textos de IA en esas variedades y en español neutro, pero la muestra es demasiado pequeña para publicar cifras por variedad. No existe evidencia sobre code-switching. Los textos que mezclan español e inglés — comunes en contextos académicos bilingües — no han sido evaluados. Las afirmaciones de los fabricantes requieren verificación independiente. La acción de la FTC contra Workado, que afirmaba un 98% de precisión cuando, según la agencia, pruebas independientes daban un 53%, demuestra que este es un problema sistémico, no un caso aislado.
Es probable que la detección en los idiomas principales mejore a medida que se publiquen más datos y evaluaciones independientes, pero eso dependerá de inversiones concretas en datos y modelos, no de promesas. Desde detector-de-ia.com, nuestro compromiso es publicar datos de rendimiento propios a medida que estén disponibles y ser transparentes sobre lo que nuestra herramienta puede y no puede hacer. Para contexto sobre texto mixto y textos cortos, consulta nuestras guías especializadas; si empiezas desde cero, lee primero qué es un detector de IA. Más información en cómo funciona, nuestras preguntas frecuentes, o conoce al equipo en sobre nosotros. Tu texto se analiza según nuestra política de privacidad.
Preguntas frecuentes
¿Los detectores de IA funcionan en texto en español?
Funcionan, pero la evidencia disponible indica que con menor precisión que en inglés. Las evaluaciones independientes suelen obtener resultados más bajos que las cifras que anuncian los fabricantes, incluso en inglés. Para español específicamente, la evidencia es aún más limitada y no existen benchmarks independientes a gran escala.
¿Cuál es el detector más preciso para texto en español?
No existe un benchmark independiente que permita responder esta pregunta con datos verificados. Varios fabricantes declaran soporte para español, pero declarar soporte no equivale a demostrar precisión. Nuestro detector de IA está diseñado solo para español y publica los resultados de su prueba sellada, pero no ha sido evaluado externamente. Recomendamos usar siempre dos o más detectores.
¿Por qué las pruebas independientes dan menos precisión que la que anuncian los fabricantes?
Porque las cifras de los fabricantes suelen obtenerse con sus propios textos y criterios, a menudo con texto de IA sin editar ni parafrasear. En el mundo real, los textos son editados, parafraseados y mixtos. En 2025, la FTC aprobó una orden contra una empresa que anunciaba un 98% de precisión cuando, según la agencia, pruebas independientes mostraron un 53% en contenido general. Esta brecha entre lo anunciado y lo real es un problema documentado en toda la industria.
¿Turnitin funciona en español?
Sí — Turnitin lanzó un modelo dedicado para español, entrenado con escritura en este idioma. Sin embargo, según su propia documentación, el modelo solo se entrenó con versiones anteriores de los modelos de OpenAI que usa ChatGPT y no incluye modelos más recientes. Turnitin no ha publicado tasas de precisión específicas para su modelo español. Consulta nuestra guía de Turnitin.
¿Debo confiar en un solo detector para texto en español?
No. La brecha de precisión es mayor para español que para inglés según la evidencia disponible. Resultados consistentes en dos o más herramientas son significativamente más informativos que cualquier puntuación individual. Y en todos los casos, la evidencia de proceso (borradores, historial de versiones, notas de investigación) es más sólida que cualquier porcentaje de un detector.