La detección de texto generado por inteligencia artificial no funciona exactamente igual en todos los idiomas. Muchas herramientas de detector de IA se entrenaron inicialmente con textos en inglés, lo que puede afectar su precisión al usarlas con contenido en español. En este artículo analizamos qué cambia al detectar texto de IA en español frente a inglés y qué implicaciones prácticas tiene para el usuario hispanohablante.
Abordaremos qué herramientas soportan español, las diferencias lingüísticas que influyen en la detección y daremos recomendaciones para interpretar los resultados en español de forma prudente. No se trata de proclamar un «ganador», sino de entender las diferencias y cómo abordarlas con conocimiento.
Contenido
- Soporte de los detectores de IA en español vs inglés
- ¿Por qué cambia la detección según el idioma?
- Ejemplos prácticos: español vs inglés en detección
- Recomendaciones para el usuario hispanohablante
- Errores frecuentes al comparar resultados entre idiomas
- Preguntas frecuentes
Soporte de los detectores de IA en español vs inglés
Hasta hace poco, muchos detectores de texto de IA solo funcionaban bien en inglés. En 2026 varias herramientas líderes ya declaran soporte explícito para español, aunque con matices:
- Turnitin lanzó en 2024 un modelo específico para texto en español, entrenado con ejemplos en español y capaz de detectar texto generado con las versiones de ChatGPT de entonces. En su documentación señalaron que el modelo de español es diferente al de inglés y que sus capacidades no son idénticas. La detección de texto parafraseado o «bypasser» estaba limitada a entregas en inglés según su documentación pública.
- GPTZero recibió críticas iniciales por sesgo hacia textos de estudiantes no nativos en inglés. En respuesta, reforzó su enfoque multilingüe durante 2025. Hoy afirma soportar múltiples idiomas, incluido el español, pero su documentación sigue indicando que funciona mejor con textos largos y prosa en inglés.
- Copyleaks declara soporte para más de 30 idiomas, incluido el español, y publica métricas favorables en su documentación comercial.
- Originality.ai incorporó un modelo multilingüe dedicado: al pegar texto en español su plataforma automáticamente usa un modelo entrenado para varios idiomas.
- Pangram reporta una precisión superior al 99% en varios idiomas incluido el español según sus propios benchmarks, aunque esas cifras deben leerse como resultados del proveedor y no como consenso independiente.
En resumen, ya es posible detectar texto de IA en español con varias herramientas, pero casi todas tuvieron el inglés como prioridad inicial. Muchas han desarrollado modelos separados o ajustado sus algoritmos para el español, y aunque los proveedores destaquen soportar «X idiomas», en la práctica siguen apareciendo diferencias frente al inglés.
¿Por qué cambia la detección según el idioma?
Existen razones claras por las que un detector de IA en español puede arrojar resultados distintos al inglés. Estas diferencias provienen tanto de cómo se construyen las herramientas como de las características propias de cada lengua.
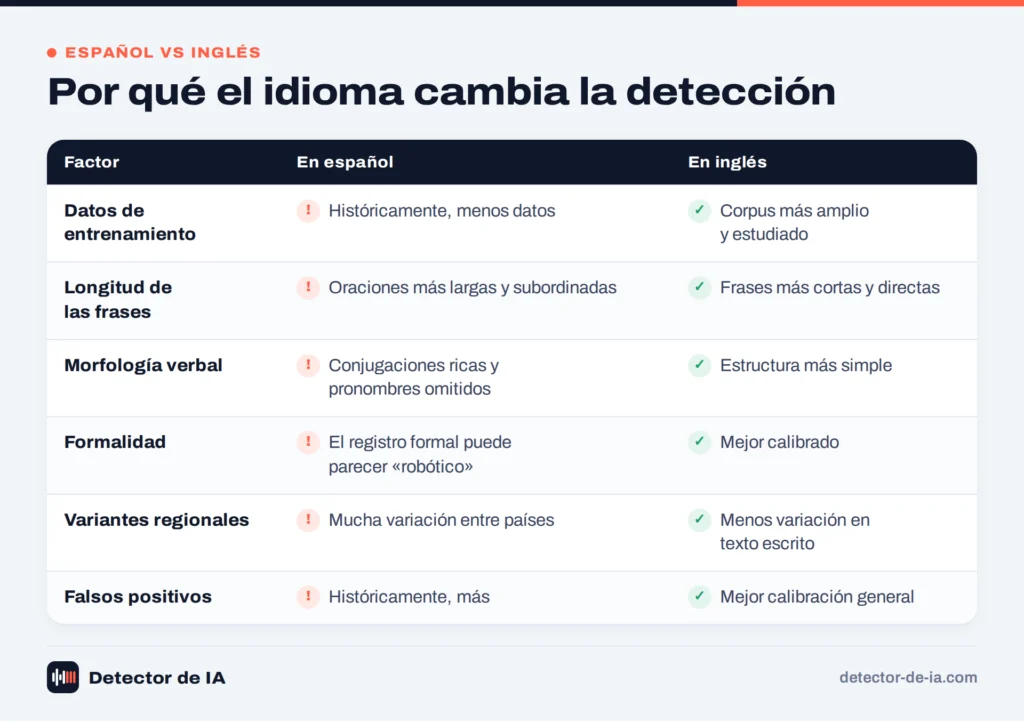
| Factor | Impacto en español | Impacto en inglés |
|---|---|---|
| Datos de entrenamiento | ⚠️ Menos datos disponibles históricamente | ✅ Corpus más amplio y mejor estudiado |
| Longitud de frases | ⚠️ Oraciones más largas y subordinadas; pueden confundir al detector | ✅ Frases más cortas y directas; más fácil de analizar |
| Morfología verbal | ⚠️ Conjugaciones ricas + omisión de pronombres; patrones distintos | ✅ Estructura más simple; bien cubierta por los modelos |
| Formalidad y estilo | ⚠️ Registro formal puede parecer «robótico» al detector | ✅ Mejor calibrado para distinguir formalidad humana vs IA |
| Dialectos regionales | ⚠️ Alta variación (España, México, Argentina, etc.) | ✅ Menos variación formal en texto escrito |
| Falsos positivos | ⚠️ Tendencia histórica a más falsos positivos | ✅ Mejor calibración general |
Comparativa de factores que afectan la detección de IA según el idioma.
Veamos cada factor con más detalle:
Datos de entrenamiento dominados por el inglés
La mayoría de detectores se entrenaron con enormes corpus de texto en inglés. Esto crea un sesgo: la herramienta «aprende» qué patrones son normales en inglés pero carece de ese conocimiento profundo en español. Aunque hoy existen más datos multilingües, la investigación sigue mostrando que muchos detectores se optimizaron primero en inglés y su generalización a otros idiomas no siempre es equivalente.
Longitud y estructura de las frases
En registros formales o académicos, el español admite oraciones extensas con múltiples comas, subordinación y conectores. Una oración académica en español puede extenderse por varias líneas donde en inglés serían dos oraciones más cortas. Una herramienta entrenada en inglés podría interpretar ese patrón como «exceso de uniformidad», un rasgo a veces asociado a texto de IA.
Morfología verbal y pronombres
El español es más rico en flexiones verbales. Un verbo indica persona, número, tiempo y modo, lo que permite omitir sujetos frecuentemente («Corrió a casa» donde en inglés necesitas «She ran home»). Las IA entrenadas principalmente en inglés podrían producir construcciones menos habituales en español, y los detectores podrían no reconocer como natural una secuencia de verbos conjugados distintos sin pronombres explícitos.
Formalidad, dialectos y corpus
En textos formales en español es común un estilo impersonal con voz pasiva refleja («se observa que…») y muletillas académicas que podrían parecer demasiado estructuradas al detector. Además, el español presenta variaciones regionales significativas: «ordenador» vs «computadora», «vosotros» vs «ustedes». Si el detector fue entrenado con texto mayoritariamente de un país, cierto léxico regional puede resultarle extraño y aumentar los falsos positivos.
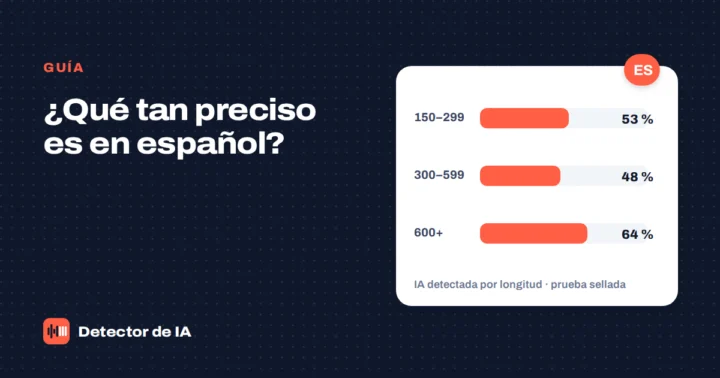
Por eso, al construir nuestro detector cuidamos especialmente este punto: la mitad de los textos web humanos de su prueba sellada procede de dominios latinoamericanos, y los textos de IA incluyen variedades de España, México, Argentina, Colombia y español neutro, en 13 géneros. Aun así, en esa prueba el texto web informal se marcó por error algo más a menudo (entre 1 de cada 70 y 1 de cada 55 textos, según la longitud) que el conjunto de textos humanos (alrededor de 1 de cada 80, y 1 de cada 70 a partir de 600 palabras). Puedes ver cómo se construyó la prueba en nuestra metodología.
La literatura reciente sobre detección multilingüe confirma estas disparidades: varios trabajos señalan que los detectores suelen rendir mejor en inglés y que ciertos detectores mostraban más falsos positivos en idiomas distintos del inglés, incluyendo el caso de estudiantes ESL escribiendo en inglés.
Ejemplos prácticos: español vs inglés en detección de IA
Veamos escenarios concretos que ilustran las diferencias:
1. Texto académico en español (original humano)
Un ensayo universitario escrito por un estudiante en español suele contener oraciones largas, terminología técnica y estructura formal. Un detector entrenado en inglés podría subrayar frases como «Por lo tanto, se puede afirmar que…» como potencialmente generadas por IA, cuando en realidad son convencionales en redacción académica en español.
Riesgo: Falso positivo. El profesor podría recibir una alerta injustificada. Por ello, en textos académicos en español es crucial revisar cualquier alerta con ojo humano.
2. Artículo periodístico en ambos idiomas
Un artículo de noticias en inglés probablemente será analizado con mayor confianza por el detector. El mismo tipo de artículo en español podría generar más indecisión: algunos detectores devuelven «posiblemente humano» o «incertidumbre» donde en inglés darían un veredicto más firme. Ciertos giros periodísticos del español (voz pasiva refleja, fechas al inicio) podrían parecer patrones artificiales al detector.
Riesgo: Resultados inconsistentes entre idiomas. Un porcentaje intermedio en español (o un «Incierto» en nuestro detector) no es prueba definitiva.
3. Texto traducido vs texto original
Traducir un texto de IA del inglés al español no garantiza eludir la detección. La traducción altera las señales estadísticas de forma impredecible: puede eliminar algunas señales de IA pero añadir otras nuevas (calcos literales, orden extraño de palabras). Un detector multilingüe bien entrenado puede captar algunas de esas anomalías, pero no hay garantía en ninguna dirección.
A la inversa, un texto humano en español traducido al inglés podría verse penalizado porque el inglés resultante suena simplificado o «robotizado».
Riesgo: Resultados distorsionados en ambas direcciones. Analiza siempre en el idioma original.
4. Texto de IA adaptado manualmente al español
Distinto a la traducción automática: si alguien genera contenido en inglés con IA y luego lo adapta al español cuidando el estilo, el resultado puede lucir natural. Sin embargo, ciertas estructuras lógicas de fondo (enumeraciones repetitivas, párrafos con la misma construcción) pueden delatar el origen artificial. Un detector avanzado podría notar que todo el documento sigue un patrón demasiado uniforme.
Lección: Cuando se adapta contenido entre idiomas, conviene rehacer el estilo libremente. Aun así, si la esencia proviene de IA, siempre existe algún riesgo de detección.
Recomendaciones para el usuario hispanohablante
Para docentes, editores, periodistas y cualquier usuario que trabaje con texto en español, estas son las pautas más importantes:
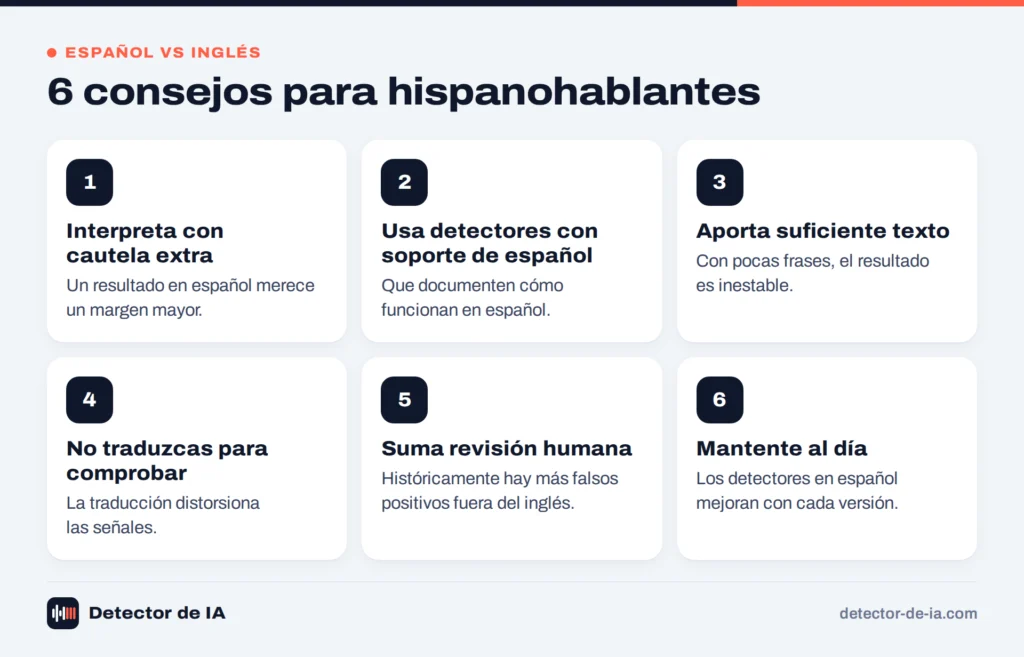
- Interpreta resultados en español con margen extra de cautela. Una puntuación de «posiblemente IA» en español merece una segunda revisión antes de cualquier conclusión. Los propios proveedores recomiendan tratar los informes como orientativos.
- Usa herramientas con soporte explícito para español. Prioriza detectores que documenten soporte para español y, si es posible, evaluación específica para ese idioma. Evita los que solo están optimizados para inglés. Nuestro detector de IA gratuito analiza solo textos en español, con un modelo de lenguaje en español y un clasificador entrenado con textos escritos en español por personas y por IA. Necesita al menos 150 palabras.
- Proporciona suficiente texto. Los detectores necesitan volumen para dar resultados estables. Con pocas frases aumenta la incertidumbre, especialmente en español donde la variabilidad sintáctica es alta. Introduce párrafos completos: herramientas como Turnitin exigen un mínimo de 300 palabras. Nuestro detector no analiza textos de menos de 150 palabras y ajusta sus umbrales por tramos de longitud; lo explicamos en textos cortos y fiabilidad.
- No traduzcas para comprobar. Traducir un texto español al inglés para usar un detector monolingüe distorsiona los patrones y genera resultados poco fiables. Analiza siempre en el idioma original.
- Complementa con revisión humana. La tasa de falsos positivos ha sido históricamente mayor fuera del inglés, según la investigación citada más arriba. Un texto legítimo tiene más probabilidad de ser marcado incorrectamente. Ante cualquier resultado dudoso, revisa manualmente considerando el contexto, el tipo de documento y el autor.
- Mantente actualizado. Lo que en 2024 era menos fiable en español, en 2026 ya funciona mejor. Revisa actualizaciones de tu herramienta: puede haber nuevos modelos o ajustes específicos para español.
¿Quieres comprobar cómo se comporta un detector con tus propios textos en español? Prueba nuestro detector de IA gratuito directamente — no necesitas registrarte. Y si quieres entender mejor el proceso técnico detrás del análisis, visita nuestra guía sobre cómo funciona el detector.
Errores frecuentes al comparar resultados entre idiomas
Al usar detectores de IA en distintos idiomas, evita estos errores comunes:
- Creer que un porcentaje significa lo mismo en todos los idiomas. Un 10% de «texto sospechoso» no tiene el mismo peso en español que en inglés. Algunos sistemas aplican umbrales distintos según el idioma o el nivel de confianza del modelo. No compares cifras directamente entre idiomas.
- Asumir que si pasa en un idioma, pasará en otro. Un texto traducido puede desencadenar flags diferentes. Podrías haber eliminado algunas señales pero añadido otras nuevas. Cada idioma tiene matices que pueden disparar o silenciar las alarmas.
- Extrapolar la metodología del inglés al español. Señales como la perplejidad baja o la falta de burstiness se estudiaron principalmente en inglés. En español, los valores «normales» pueden ser diferentes. Un texto español legítimo puede tener perplejidad distinta simplemente por la naturaleza del idioma.
- Interpretar «0% IA» como garantía absoluta. En español, un resultado limpio a veces refleja que el modelo no está lo suficientemente seguro para etiquetar. Un 0% en español merece un poco más de escrutinio que un 0% en inglés.
- Confiar solo en la herramienta sin revisión humana. En español, siempre es buena idea que un humano competente revise el texto sospechoso. Los detectores dan pistas, pero la revisión experta (comparando con otros trabajos del mismo autor, evaluando el contexto) sigue siendo la última palabra.
- Usar un detector solo para español con textos en otros idiomas. El Detector de IA está diseñado solo para español: con un texto en inglés o en otra lengua no obtendrás un resultado válido. Para esos casos, usa una herramienta que documente soporte para ese idioma y, si el documento mezcla idiomas, analiza solo la parte en español (mínimo 150 palabras).
Conclusión: navegando la detección multilingüe con conocimiento
En 2026, la detección de texto de IA en español ha avanzado considerablemente, aunque las diferencias frente al inglés siguen dependiendo de la herramienta, del tipo de texto y del contexto. Los hispanohablantes cuentan ya con detectores entrenados para español, pero deben usarlos con criterio: aportando suficiente contexto, interpretando los resultados con cautela y complementando con juicio humano.
La meta es la misma en cualquier idioma: fomentar la integridad y la originalidad. Con las herramientas adecuadas y un entendimiento claro de sus límites, podemos lograrlo sin importar si escribimos en español, inglés o cualquier otra lengua. Si tienes más dudas, revisa nuestras preguntas frecuentes o conoce más sobre el proyecto en nuestra página sobre nosotros.
Preguntas frecuentes
¿Los detectores de IA funcionan igual de bien en español que en inglés?
No exactamente. Los detectores han tendido a rendir mejor en inglés porque muchos se desarrollaron primero con mayor énfasis en ese idioma. Hoy muchos ya soportan español con resultados útiles, pero aún pueden mostrar ligeras caídas de rendimiento o más indecisión. La diferencia exacta depende del detector y del tipo de texto. Conviene interpretar resultados en español con más cautela que en inglés.
¿Por qué es más difícil detectar texto de IA en español?
No siempre es más difícil, pero influyen varios factores: el español tiene frases más largas que pueden parecer patrones repetitivos, su gramática (morfología verbal, omisión de pronombres) difiere del inglés, y la diversidad de dialectos añade complejidad. Además, muchos detectores se entrenaron primero en inglés, lo que históricamente limitó su rendimiento en otros idiomas.
¿Qué herramientas detectan contenido de IA en español?
Varias herramientas ya soportan español: Turnitin tiene un modelo específico para español, GPTZero declara soporte multilingüe, Copyleaks ofrece detección en más de 30 idiomas, Originality.ai incorporó un modelo multilingüe dedicado, y Pangram publica benchmarks multilingües favorables. Verifica siempre en la documentación de cada herramienta que español esté listado explícitamente.
¿Debería traducir el texto al inglés para detectarlo mejor?
No es recomendable. Traducir un texto español a inglés para pasarlo por un detector distorsiona la estructura y las palabras, pudiendo hacer que un texto humano parezca artificial o viceversa. Lo ideal es usar un detector que analice directamente el texto en español. Traducir texto de IA al español con la esperanza de que no lo detecten tampoco es una estrategia fiable: la traducción altera las señales de forma impredecible y el resultado puede ir en cualquier dirección.
¿Cuántas palabras en español necesito para una detección fiable?
Se recomienda proporcionar párrafos completos de al menos 150-300 palabras. Herramientas como Turnitin exigen un mínimo de 300 palabras para generar un informe de IA. Nuestro detector no analiza textos de menos de 150 palabras, porque con muy pocas palabras el resultado se vuelve inestable. Cuanto más largo sea el texto, más confiable será el resultado. Para textos cortos como notas o tuits, toma los resultados con cautela.
¿Los detectores cometen más falsos positivos en español?
Históricamente sí se observó esa tendencia, especialmente con textos escritos en idiomas distintos del inglés. Los modelos confundían un estilo diferente con señales de IA. En 2026 esta brecha se ha ido cerrando con mejores entrenamientos multilingües, pero aún podría haber una ligera diferencia según la herramienta. Ante cualquier resultado dudoso en español, conviene una revisión manual antes de sacar conclusiones.